






Az Nvidia néhány napja mutatta be speciális, mesterséges intelligenciával kapcsolatos feladatokra koncentráló SoC egységét, az ARM alapú processzormagokkal ellátott Grace processzort, amiről egyik korábbi hírünkben írtunk részletesebben – már amennyire ezt a szűkszavú bejelentés engedte. Az ígéretes megoldás várhatóan 2023 folyamán debütálhat, valamint több nagy és fontos szuperszámítógép-fürtben is helyet kaphat, azaz ütőképes versenyzőnek ígérkezik, az Intel vezetése mégsem érzi úgy, hogy az Nvidia újítása közvetlen veszélyt jelenthet a vállalat adatközpont üzletágára.
Pat Gelsinger, az Intel új vezérigazgatója szerint az Ice Lake szerverprocesszorokat az elmúlt hét folyamán meglehetősen pozitívan fogadta a piac. Ebben a processzorcsaládban igen komoly mértékben bővültek az AI-val kapcsolatos képességek is. Szerinte az Nvidia újdonsága lényegében az Intel friss termékeire reagál, nem ők reagálnak az Nvidia friss processzorára. Pat Gelsinger szerint az mesterséges intelligencia terén kamatoztatható képességekkel rendelkező processzorok területe olyan terep, ahol az Intel a drámai vezető.
Az Intel kétségtelenül jobb helyzetben van ebben a szegmensben, hiszen az Intel Xeon processzorokat rendkívül széles körben használja a piac a dedukcióval kapcsolatos terhelésformákra, ennek megfelelően a szoftverfejlesztők is odafigyelnek arra, hogy megfelelően optimalizálják alkalmazásaikat ezekre a processzorokra. A Xeon Scalable család modern tagjai már most is tartalmaznak mesterséges intelligenciát érintő extrákat, a következő generációs termékek pedig kétségtelenül még több ilyen képességgel gazdagodnak majd az elkövetkező évek során.
A DL Boost ernyője alatt már most is elérhető az AVX512-VNNI, illetve az AVX512_BF16 utasításkészlet, amelyek közül előbbi a Cascade Lake és az Ice Lake, utóbbi viszont csak a Cooper Lake modelleknél használható. Mindkét megoldás ütőképesnek mondható nagy általánosságban, legalábbis az Intel belsős tesztjei alapján, ahol a rájuk optimalizált algoritmusok akár 15x gyorsabban futnak ezeken a processzorokon, mint az Nvidia grafikus processzorain.
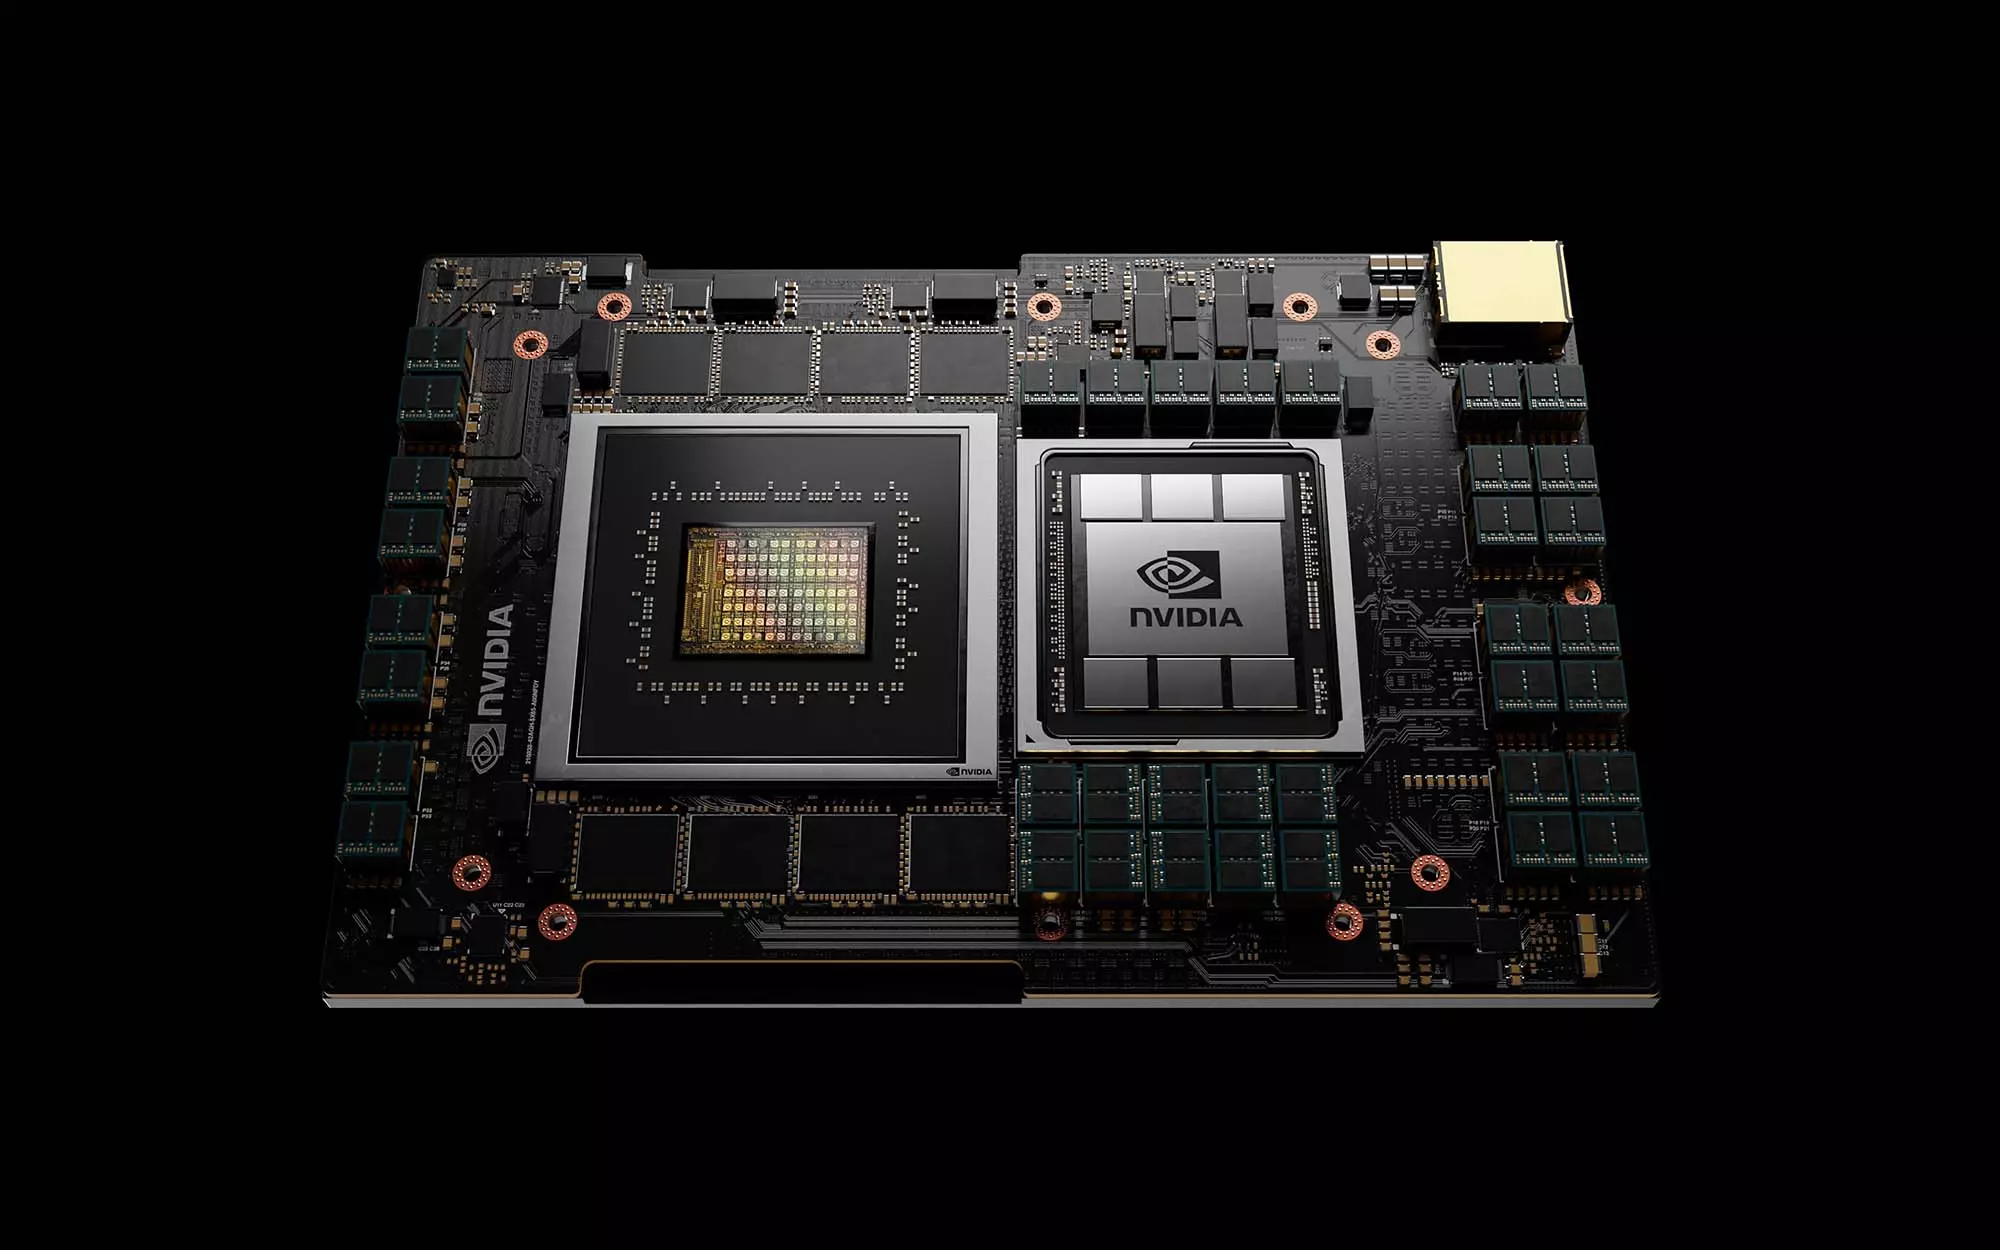
Teljesítmény terén az Nvidia Grace sem áll rosszul az első adatok alapján, ugyanis a gyártó szerint több, mint tízszer gyorsabbnak bizonyulhat majd különböző AI és HPC terhelésformák alatt, mint napjaink x86-os processzorai. Persze ezeket a kijelentéseket egyelőre érdemes távolságtartóan fogadni, hiszen a 2023-as tényleges megjelenésig még sok minden változhat a piacon – időközben az AMD és az Intel sem ül majd tétlenül a babérjain, az teljesen biztos.
Azt is fontos kiemelni, hogy az Nvidia Grace SoC egysége egy GPU mellett foglal majd helyet ugyanazon a nyomtatott áramköri lapon, vagyis nem önállóan értékesíti a vállalat. Azaz a Grace ugyan tartalmazhat majd számos olyan extrát, amelyek jól jöhetnek az AI/HPC szegmensben, ám a speciális grafikus processzornak talán még egy fokkal nagyobb szerepe lesz az egyenletben, hiszen az is tartalmaz majd számos optimalizációt, amelyek jól jönnek a piacon.
A lényeg igazából nem is ez, hanem az, hogy az NVLINK összekötőn keresztül igen tempós kommunikációra nyílik lehetőség a GPU, a CPU és a RAM között, amire jelenleg nincs igazán lehetőség, hiszen az Nvidia gyorsítókártyái az NVLINK helyett PCI Express alapú kapcsolaton keresztül kommunikálhatnak a processzorral és a rendszermemóriával, mert nincs NVLINK támogatással ellátott CPU platform – lényegében ezért építettek sajátot.
Érdekesség egyébként, hogy az Intel már 2022 folyamán rendelkezni fog egy hasonló platformmal, ugyanis érkeznek a 4. generációs Intel Xeon Scalable processzorok, amelyek a Sapphire Rapids kódnevet viselik. Ezek a termékek maximum 56 processzormaggal és 112 szállal rendelkeznek majd, melléjük pedig egy 100 milliárd tranzisztorból álló Ponte Vechio GPU kerülhet. Ez az összeállítás a jövőre munkába álló Aurora szuperszámítógép-fürt fedélzetén már használatban is lesz.
Maga a GPU várhatóan 1 PFLOP/s-os maximális FP16-os számítási teljesítményt kínálhat, ami 1000 TFLOP/s-os szint, vagyis nagyjából háromszor lesz gyorsabb, mint az Nvidia aktuális A100-asa, ami 312 TFLOP/s-os FP16-os számítási teljesítményre képes. Hogy erre mivel reagál az Nvidia? Néhány negyedéven belül egészen biztosan megtudjuk.
























