A Google anyacége, az Alphabet tulajdonában lévő londoni DeepMind fejlesztői létrehoztak egy olyan új rendszert, amely mindenféle emberi közbeavatkozás nélkül rövid idő alatt képes magas szinten elsajátítani az említett táblajátékokat. Az AlphaZero tavaly kezdte pályafutását, a gó emberi bajnokait megverő AlphaGo egy kevésbé specializált változataként, mely utóbbi 2016-ban megverte Lee Sedolt, a világ egyik legjobb gójátékosát.
Az AlphaZero elődjével szemben nem úgy tanul, hogy emberi játékosok játszmáinak millióit elemzi, majd ezekből dolgoz ki egy sokoldalúan adaptálható saját stratégiát, hanem gyakorlatilag csak megkapja az adott játék szabályait, és onnantól maga találja ki, hogyan érdemes játszani. Az új rendszer esetében 13 napba telt, mire a világ legjobbja lett, és megverte az AlphaGot. Ehhez a játékok millióit játszotta le maga ellen a megerősítéses tanulás nevű módszerrel haladva, saját hibáiból és sikereiből tanulva.
Az AlphaZero így ráadásul nem is csak egy játékra specializálódott: a gótanuláshoz alkalmazott stratégiát más táblajátékokra is képes volt alkalmazni, így rövid idő alatt sakkozni és sógizni is úgy megtanult, hogy képes volt megverni az emberi játékosokat már korábban leköröző szoftvereket. A sakkbajnok Stockfisht 9 óra öntanulás után, a sógizó Elmot 12 óra után verte meg.
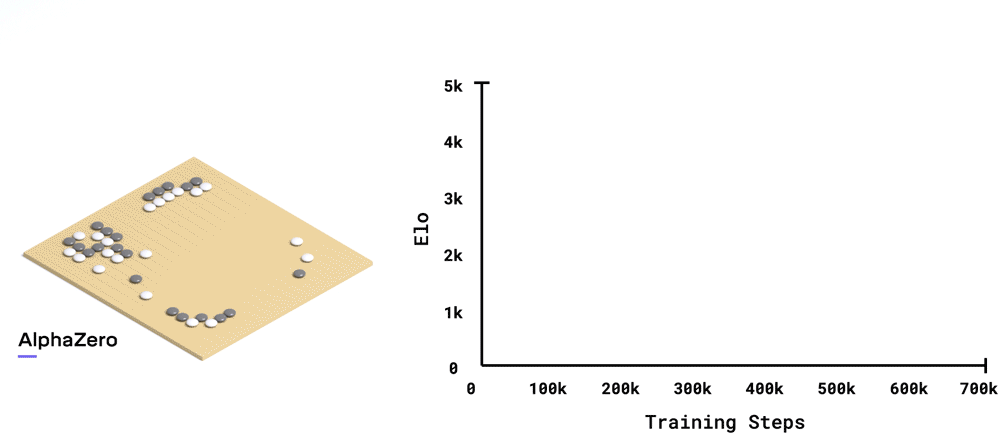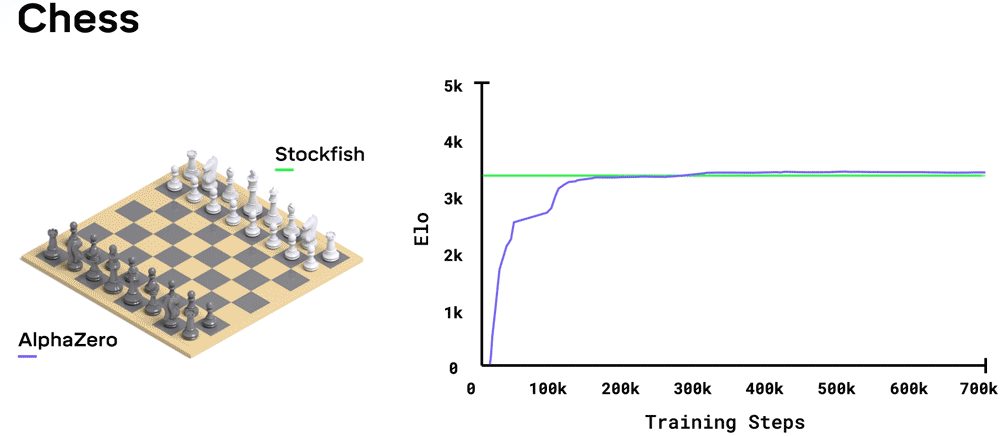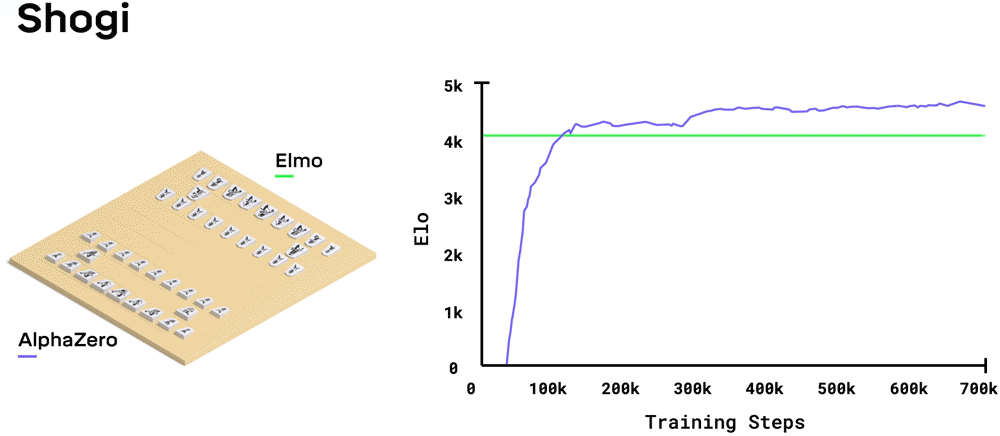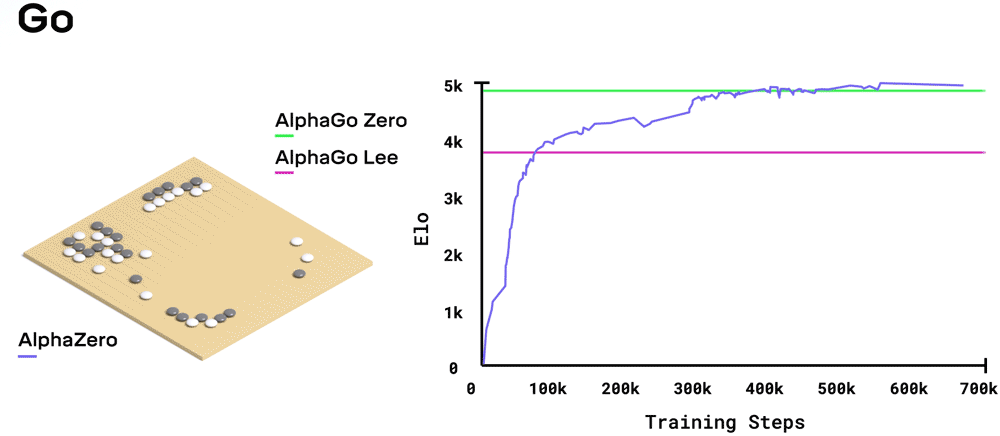
A DeepMind fejlesztői szerint az AlphaZero fontos lépést jelent egy olyan mesterséges intelligencia felé, amely bármire képes megtanítani saját magát. Annyiban ugyanakkor még korlátozott a rendszer, hogy bár sokoldalúan tanulékony, egyszerre mindig csak egy dolgot tud. Vagyis ha megtanult sakkozni, gózni vagy sógizni csak akkor tud megtanulni, ha sakktudása „törlődik”, és gyakorlatilag lenullázódik a rendszer. Ennyiben tehát az AlphaZero még elmarad az emberi játékosoktól, akik egyszerre több játékot is ismerhetnek.
Az AlphaZero működéséhez elképesztő számítási kapacitásra van szükség: a rendszer 5000 TPU-t, azaz tenzor feldolgozó egységet használ, ezek a Google saját fejlesztésű, kifejezetten gépi tanuláshoz létrehozott chipjei. Ez pedig minden olyan játék megtanulásához elég lehet, amelyhez a szabályok ismerete elegendő a döntéshozatalhoz. A következő célpontot az olyan játékok jelenthetik, mint a póker, ahol a tökéletlen információkkal kell dolgozni, mivel egyik játékos sem ismeri a másik lapjait, illetve a multiplayer videojátékok.