

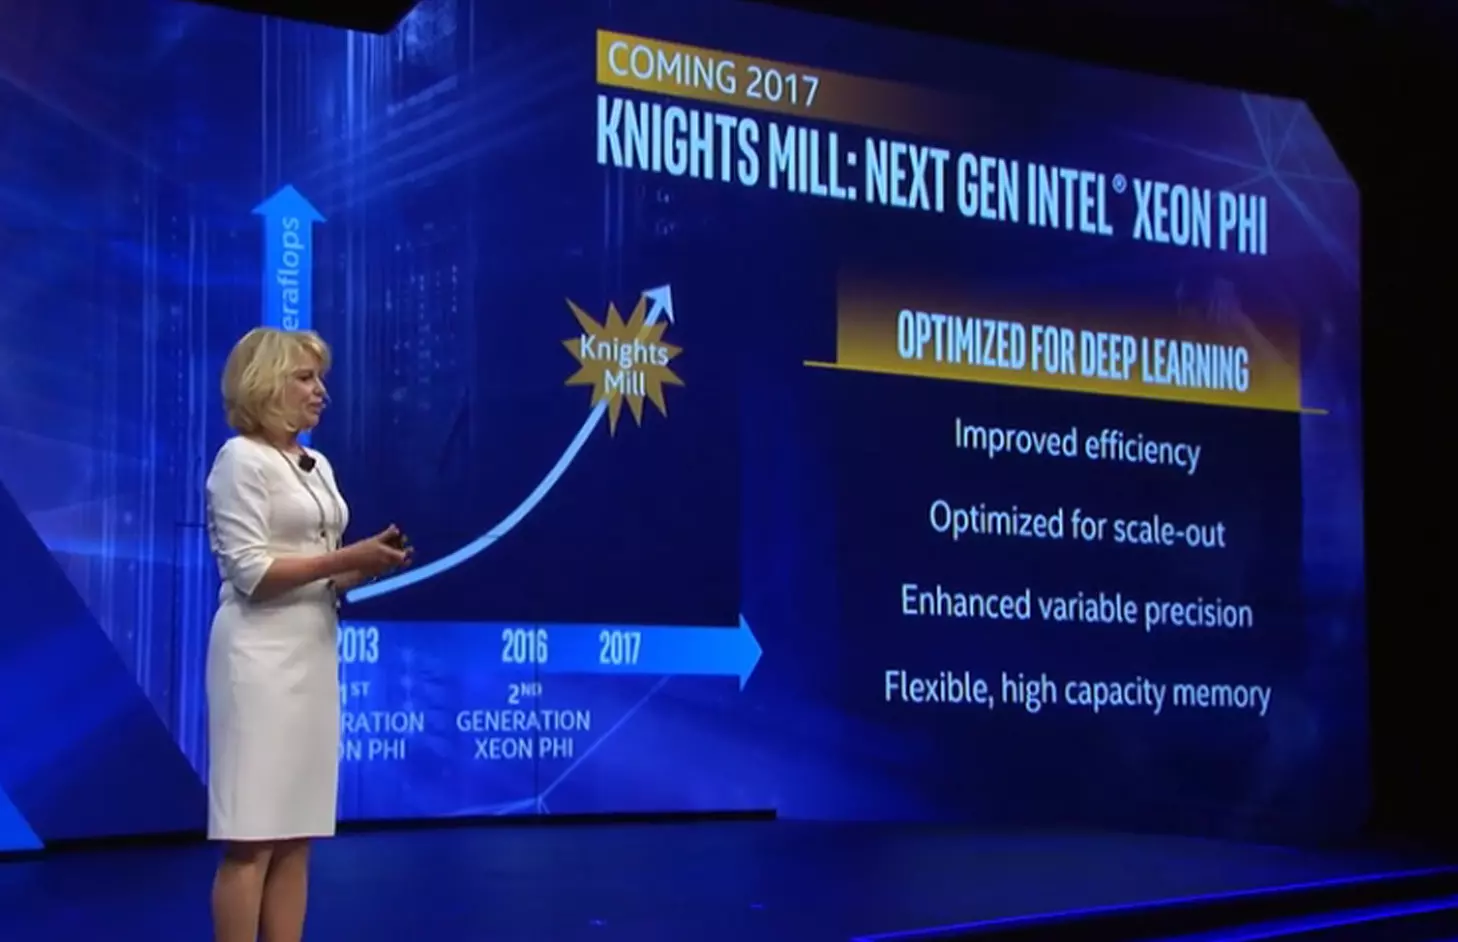





Az Intel az IDF 2016 alkalmával elárult egyet s mást a Xeon Phi sorozat legújabb tagjáról, a 2017 folyamán érkező Knights Mill modellről, amellyel kapcsolatban még így is nagyon-nagyon sok nyitott kérdés maradt.
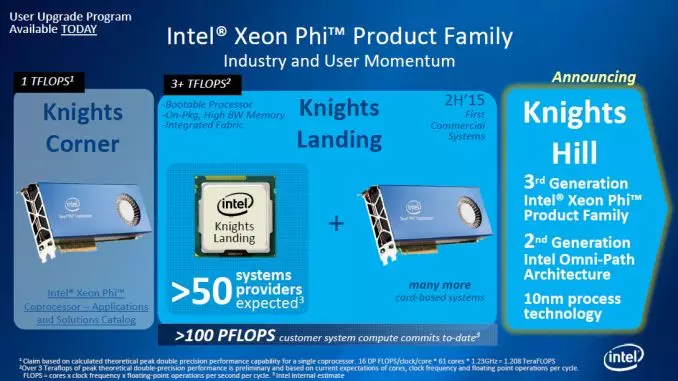
Az első furcsaság az, hogy a 2014-ben publikált tervek alapján a jelenlegi Knights Landing modellek utódjaként a Knights Hillnek kellett volna érkeznie, amely már 10 nm-es csíkszélességgel készül, helyette azonban a Knights Mill modellről szólt a bemutató, a Knights Hillről nem is esett szó. Mivel a 10 nm-es csíkszélesség alkalmazása egy ekkora, ennyire bonyolult chip esetén 2017 folyamán még aligha kivitelezhető, így könnyen lehet, hogy a Knights Hill érkezése előtt piacra dobnak egy köztes modellt, ami a Knighst Mill lesz – legalábbis ez a leghihetőbb forgatókönyv. Idővel természetesen kiderül, mi a pontos helyzet.
A Knights Mill egyébként a mélytanulással foglalkozó piaci szegmenset veszi célba, így ennek a területnek megfelelő optimalizációkat kap. Érdekesebb dolog, hogy az új termék érkezésével elérhetővé válik a Variable Precision támogatás. Hogy ez pontosan mi, az egyelőre egy kicsit ködös, több mindent is jelenthet.
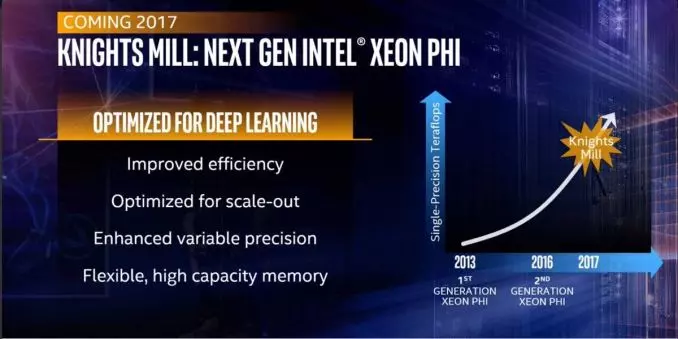
Az új Xeon Phi gyorsítók skálázódás terén is javulni fognak, így a Xeon Phi gyorsítókból álló fürtök jobb teljesítményt nyújtanak majd, mint elődeik. Hogy ezt a javulást fabric vagy interconnect téren végrehajtott fejlesztések eredményezik-e, az még nem tisztázott, az viszont biztos, hogy a Knights Landinghez hasonlóan a Knights Mill is képes lesz központi egységként, azaz klasszikus processzorként dolgozni – vagyis a Xeon Phi gyorsítókon kívül nincs feltétlenül szükség külön központi egységre vagy társprocesszorra, hiszen a termék közvetlenül is hozzá tud férni a rendszermemóriához és a processzor feladatait is elláthatja. Ez a GPU alapú gyorsítókhoz képest komoly előny, így az újdonság remek ellenfele lehet az Nvidia Tesla P100-as gyorsítójának, amely Pascal alapokon nyugszik.
























