Galéria megnyitása
Az Intel háza táján már használatban van az ARM ihlette big.LITTLE koncepció, ami elsőként a mobilpiacra szánt Lakefield dizájnban érhető tetten. Ennek lényege, hogy egy nagyteljesítményű processzormag mellett négy kisebb teljesítményű, energiahatékonyságra optimalizált processzormag is rendelkezésre áll, így a különböző munkafolyamatokat hatékony energiafelhasználás és teljesítmény mellett tudja elvégezni a rendszer.
Galéria megnyitása
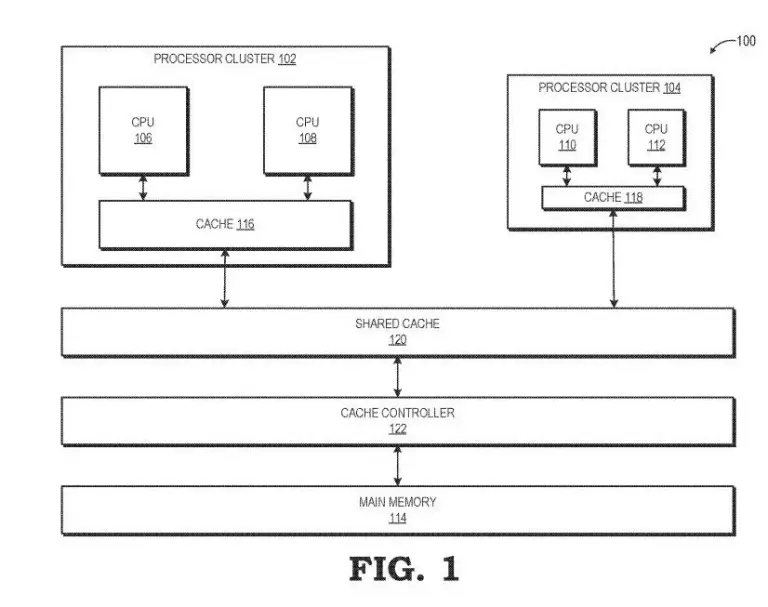
Egy viszonylag friss szabadalmi bejegyzés alapján az AMD is a big.LITTLE koncepció felé fordul a nem is oly távoli jövőben, ám a gyakorlati megvalósítás már nagyon különböző lesz. A nagy teljesítményt kínáló processzormagok, illetve energiahatékony társaik kis tömbökbe csoportosítva foglalnak majd helyet a rendszerben. Egy-egy ilyen tömb, ahol a kis teljesítményű és a nagy teljesítményű processzormag egyaránt saját elsőszintű gyorsítótárat kap, Processor Cluster néven fut majd, a két processzormag pedig egy közös, megosztott másodszintű gyorsítótárat használhat. Ezekből a kétmagos csoportokból több is lehet egy lapkán, viszont minden csoport osztozik majd az utolsó szintű gyorsítótáron, ami az L3 Cache lesz.

Az AMD megoldása az aktuális információk alapján teljesen más lesz, mint amit az Intel készített a Lakefield kapcsán, ahol nagyon minimális gyorsítótár-koherenciát láthatunk. Az egyelőre kérdés, hogy az AMD dizájnja mennyire költséghatékony és működőképes, idővel mindenképpen választ kapunk rá. Mivel azonban viszonylag friss szabadalomról van szó, még el kell telnie némi időnek addig, míg az első speciális processzorok megjelennek. A koncepció mindenképpen érdekes, a gyakorlati működés és a valós teljesítmény azonban még érdekesebb lesz.

Hírlevél feliratkozás
A feliratkozással elfogadom a Felhasználási feltételeket és az Adatvédelmi nyilatkozatot.

34 hozzászólás

A komment írásához előbb jelentkezz be!
arn
arn
2020. aug. 11. 15:30
#6

varom oket... :) jo lenne par wattos idle fogyasztasu desktoppc.

tomchee
tomchee
2020. aug. 12. 12:55

@PARASZT  sztem az ssd-k korában már értelmét vesztett funkció.

bbwtamara
bbwtamara
2020. aug. 11. 14:51
#5
  1. Szerintem nem sokatoknak esett le: Szóval a színfalak mögött a LINUX ideológia kezd kibontakozni AMD és Intel házatáján is. (igen, azt lehet szabadalmaztatni is).

  2. Büdösül érthető volt ám a cikk leírása. Bízzátok máskor inkább szakemberre a fordítást. Pláne szakmai témában! (Melyik mag hogyan szerveződik akkor, szerencsétlenek???).

thedeveloper
thedeveloper
2020. aug. 11. 9:31
#4

Remélem, hogy ebből nem az lesz, hogy a 16 magosnak marketingelt processzor valójában 8db 600MHz-s és 8db 4.8GHz magot tartalmaz majd. Ebben a formájában nem lesz összehasonlítható egy 16db homogén magot tartalmazó cpu-val, pedig a laikusok vélhetően ezt teszik majd, mielőtt gépet választanak.
Sőt, azt is el tudom képzelni, hogy majd később megjelennek olyna procik is, amik nem 50-50%-ban tartalmaznak majd lassú és gyors magokat, hanem mondjuk 70-30 arányban. Azt is 16 magosnak adák majd el, csak lesz benne mondjuk 4 gyors mag és 12 lassú.
Ráadásul elég nagy kihívás ez az OS készítőknek, hogy mikor melyik csoportba tartozó magokat etessék milyen processekkel. Egy process valószínűleg lassabb magon kezdi az életét, aztán menet közben esetleg áthelyeződik egy gyorsabb magra. Mármint ha lesz még olyan szabadon. Ha nem, akkor marad a lassún.. S eljő az összehasonlíthatatlan benchmark eredmények kora. :D

BiroAndras
BiroAndras
2020. aug. 12. 10:05

@thedeveloper

Az OS tudja ide-ida pakolgatni menet közben. A program meg ha ilyen procira van írva, akkor eleve úgy rakja a feladatokat szálakra, hogy a számolásigényes dolgok külön legyenek a többitől. Már most is többnyire így van egy jól megírt szoftvernél.

ZoliS
ZoliS
2020. aug. 11. 0:13
#3

Lehet, hogy hülyeség, de én inkább a mag virtualizációt várom. Legyen mondjuk 8 mag és együtt párhuzamosan próbálják megoldani ugyanazt a feladatot, ezzel szimulálva egyetlen nagyobb teljesítményű magot. A probléma nyilván az utasítások hatákony feldarabolása, majd az eredmének újrarendezése. Persze, egy tervezőmérnök lehet 5 perc alatt megmondaná, ez miért hülyeség, de talán egyszerűbb lenne virtualizálni egy pár Thz-es magot, mint programokat optimalizálni 100 magra.

BiroAndras
BiroAndras
2020. aug. 12. 10:27

@ZoliS

Értem, hogy mit szeretnél, csak az nem működik. Ahogy már írtam, valamennyire csinálják is már ezt a modern procik, de erősen limitált, hogy mit lehet. A komoly párhuzamosítást magasabb szinten kell csinálni, amit a proci már nem lát. Például ha össze akarsz adni 1000 darab számot, akkor azt nagy eséllyel úgy írod meg, hogy végigmész az összesen és egyenként hozzáadod őket a részösszeghez. Ezt nem lehet párhozamosítani, mert a részösszeg függ az előző lépéstől. Viszont ha úgy csinálod, hogy feldarabolod a listát annyi darabra, ahány magod van, akkor a részlistákat már tudod párhuzamosan összeadni. De ezt a proci nem tudja megcsinálni helyetted. Még a fordító is csak ilyen egyszerű esetekben képes rá.


Ha a számítógépek és a programozás jövőjét nézzük, akkor valószínűleg az lesz, hogy mesterséges intelligencia fogja írni a programokat, az majd fogja tudni ügyesen kihasználni a magokat. A hardvernél pedig ezt a fejlődési irányt látom, ahogy egyre több mag fér rá egy chipre, úgy lesz egyre  több értelme a specializációnak. Most is van már CPU meg GPU egybe integrálva, és a legújabb GPU-k is már tartalmaznak specializált magokat (raytracing, AI). CPU-k esetében meg ott volt a Cell, ami a PS3-ban volt, és az x86 magok mellett volt benne sok DSP mag, ami valahol a CPU és a GPU magok közt volt komplexitásban. Ennek azért van értelme, mert egy fullos x86 mag 99%-a csak azzal foglalkozik, hogy futás közben optimalizálja a kódot, vagyis ha ezt a feladatot át lehet tolni a programozónak és a fordítónak, akkor ugyanannyi tranzisztorból sokszor nagyobb számítási teljesítményt lehet kihozni. A GPU ennek az extrém példája.

manbali82
manbali82
2020. aug. 10. 17:59
#2

Ez a big.LITTLE koncepció, valószínűleg a háttérben, mind2 proci tervező cégnél már régóta terítéken van. Nem lepne meg ha következő Microsoft oprendszer alapból támogatná a megoldást.

Végülis jó dolog az ha megoldható hogy 1-2W fogyasztás mellett menjen a proci alapszintű rendszerműveletek, netezés, filmnézés közben. Legyünk már ennyire "zöldek" :)

ha meg tudják csinálni hibátlanra az oprendszer felöli támogatást, részemről jöhet.

Mosdatlan_falusi
Mosdatlan_falusi
2020. aug. 10. 22:04

@Chavalier  lehet, hogy tévedek, de ha 4K videót akarsz lejátszani kis fogyasztás mellett, ahhoz valamilyen hardveres dekóder kell, ez pedig a GPU-ban van, nem a processzorban (jó, egy integrált GPU technikailag ott van, de valójában nem a proci számol)

_PARASZT_
_PARASZT_
2020. aug. 10. 17:40
#1

Külön proceszormagokat használni csak azért, hogy pár wattot sporoljanak soha sem költséghatékony. ARM megteheti, mert az ARM magok szószerint filléres kategóriába tartoznak, itt viszont csodálkonzék ah a felárat amit majd elkérnek bármikor is visszahozza a vilanyszámlán...

BiroAndras
BiroAndras
2020. aug. 12. 11:32

@PARASZT

Az x86 piac lehet, hogy nem zsugorodott, de közben a mobil piac óriásira nőtt és sokkal fontosabb, azt pedig szinte teljesen az ARM uralja. Szóval relatív piacvesztésről van szó, mert nem is olyan rég még az x86 volt az, ami megette a többi architektúra piacát, és szinte minen számítógépben x86 proci volt, a notebook-októl a szuperszámítógépekig, most meg az ARM eszik meg mindent. Már a legyerősebb szuperszámítógép is ARM alapú. https://www.top500.org/news/japan-captures-top500-crown-arm-powered-supercomputer/ Az energiahatékonyság az asztali PC-k kivételével mindenhol fontos, az a szegmens pedig egyre inkább jelentéktelenné válik. Sőt, az asztali PC-knél sem teljesen mindegy az energiahatékonyság. Nem a villanyszámla, vagy az üzemidő, hanem a hűtés miatt. Ma már minden procit egy adott TDP kertre terveznek, így a kisebb fogyasztás automatikusan nagyobb teljesítményt jelent.

Vissza az oldal tetejére