




Az AMD legújabb gyorsítókártyái, az Instinct MI200-as sorozat első tagjai éppen a napokban mutatkoztak be. Ezek a gyorsítókártyák a CDNA 2 architektúra köré épülnek és MCM felépítésű GPU-t tartalmaznak, ami két darab, maximum 110 aktív CU tömbbel ellátott lapkával büszkélkedik. A lapkák egyenként 29,1 milliárd tranzisztort tartalmaznak, fedélzeti memóriaként pedig 128 GB-nyi HBM2E típusú lapkát vethetnek be. A gyorsabb modell, vagyis az összesen 1408 stream egységgel ellátott MI250X esetében 95,7 TFLOP/s-os FP32-es és 95,7 TFLOP/s-os FP64-es számítási teljesítményt lehet elérni, a többi adattal kapcsolatban pedig érdemes megtekinteni korábbi hírünk táblázatát.
A fenti gyorsítókártya az Nvidia másfél éve bemutatott A100-as modellje ellen száll harcba, ami 54,2 milliárd tranzisztorból és 6912 aktív Cuda magból álló GPU-t használhat, a fedélzeti memória kapacitása viszont csak 80 GB, típusa azonban ugyanúgy HBM2E. Ez a gyorsítókártya 19,5 TFLOP/s-os FP32-es és 9,7 TFLOP/s-os FP64-es számítási teljesítményt kínál.
AI/MI terhelésformák esetén az AMD újdonsága 383 TFLOP/s, illetve TOP/s számítási teljesítményt tud elérni BF16, INT8 és INT4 terhelésformák esetén, míg az Nvidia A100 esetében 312 TFLOP/s-os FP16/BF16-os, valamint 624 TOP/s INT8 számítási teljesítmény áll rendelkezésre.
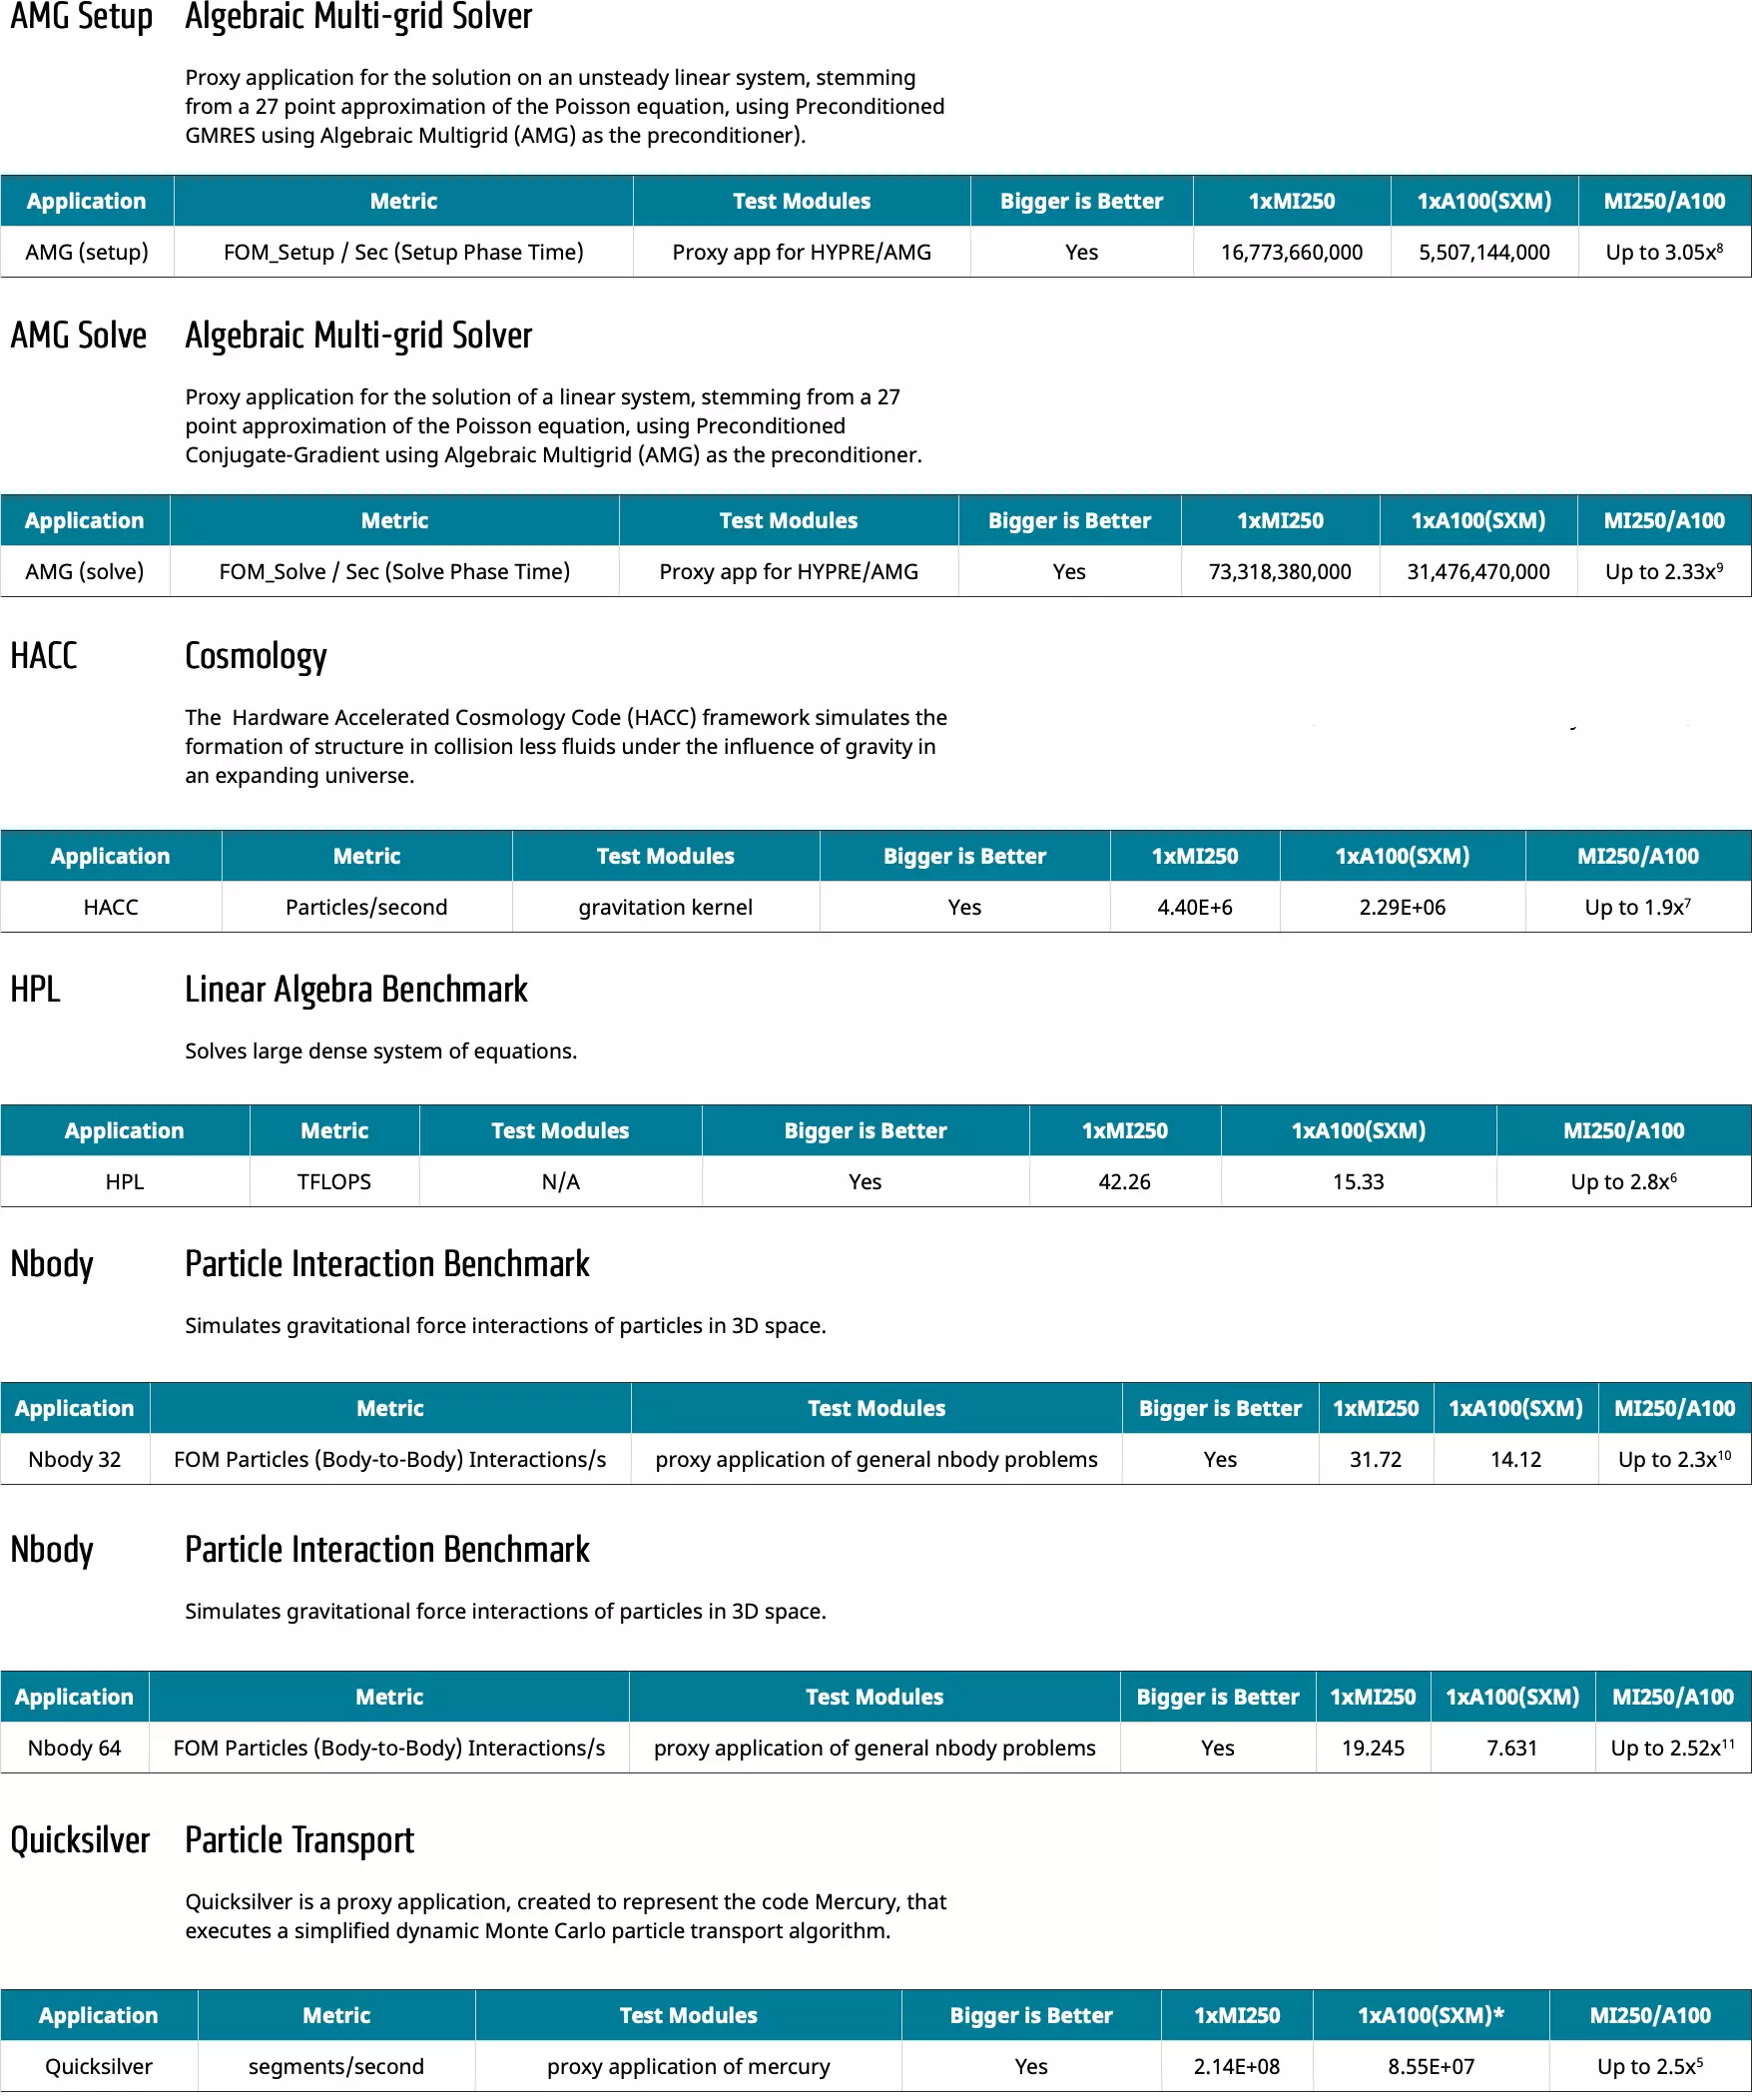
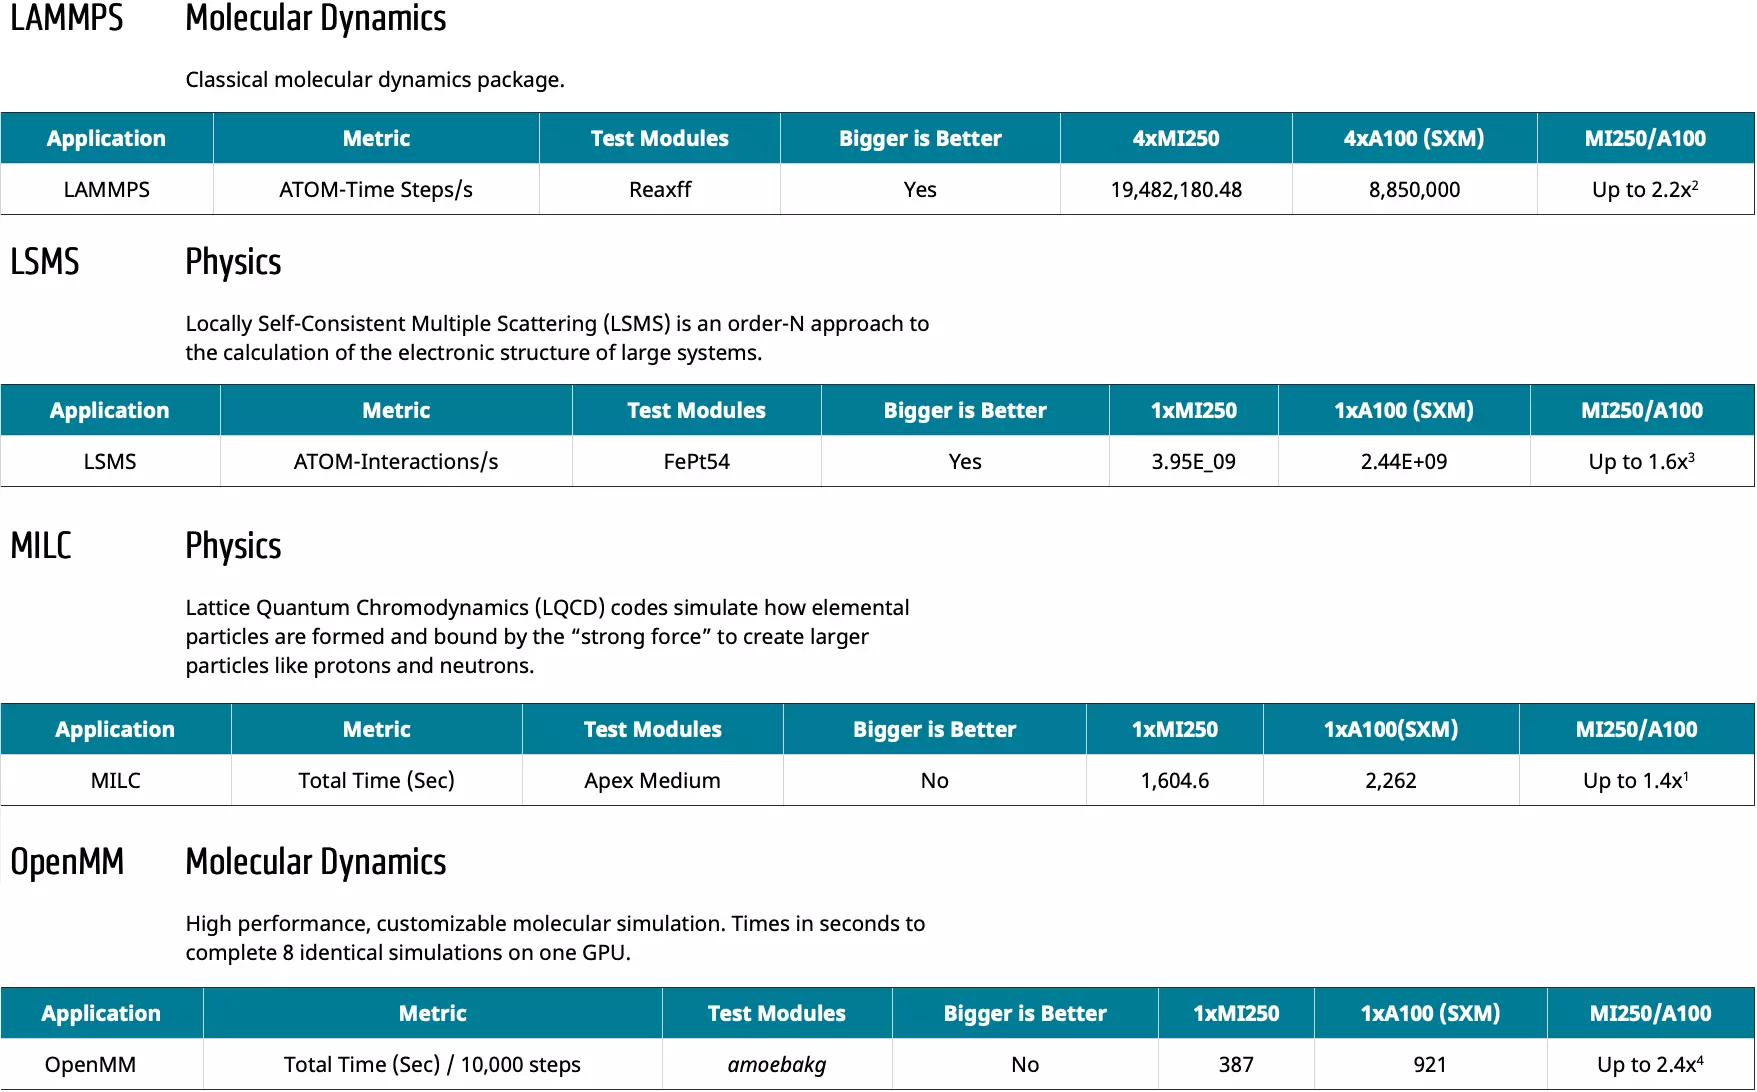
A vállalat nemrégiben elérhetővé tett egy belsős összehasonlítást, amelyből kiderül, hogy az MI250X bizonyos terhelésformák esetében igen komoly teljesítményt tud felmutatni az A100-hoz képest: a különbség akár háromszoros is lehet az AMD termék javára.
Noha a fenti eredmények szépen mutatnak, mégis csak egy másfél éve kiadott gyorsítókártyához hasonlítja az újdonságát az AMD, valamint az AI terhelésformák alatt elérhető teljesítményről sem tesz említést, ott ugyanis már az Nvidia A100 felé billenhetne a mérleg nyelve. Az igazi kérdés inkább az lesz, hogy az MI250X hogyan teljesít majd az Intel érkező Ponte Vecchio GPU-jával szemben, ami rövidesen bemutatkozhat.