






Az AMD hivatalosan is bemutatta az Instinct MI200-as gyorsítókártya-sorozat első két tagját, amelyek a MI250 és a MI250X típusjelzést viselik, valamint szó esett egy MI210-es modellről is, ami már PCI Express formátumú bővítőkártyaként kerülhet forgalomba, viszont utóbbi részletes műszaki paramétereit egyelőre homály fedi.
Az adatközpontokba szánt gyorsítókártyák közül az MI250X képviseli a csúcsot, ami lapkánként 110 darab CU tömböt foghat munkára, ahogy azt a korábbi pletyka állította. A két lapka segítségével nem kevesebb, mint 220 darab CU tömb áll rendelkezésre, ha viszont minden erőforrást engedélyeznének, akkor 224 lenne a limit – utóbbit viszont nehéz elérni, hiszen kevés olyan lapka készülne, amely teljes értékű megoldásként használható lenne. A két lapka összesen 14080 „stream egységet” eredményez, amelyek 1,7 GHz-es boost órajelen ketyegnek.
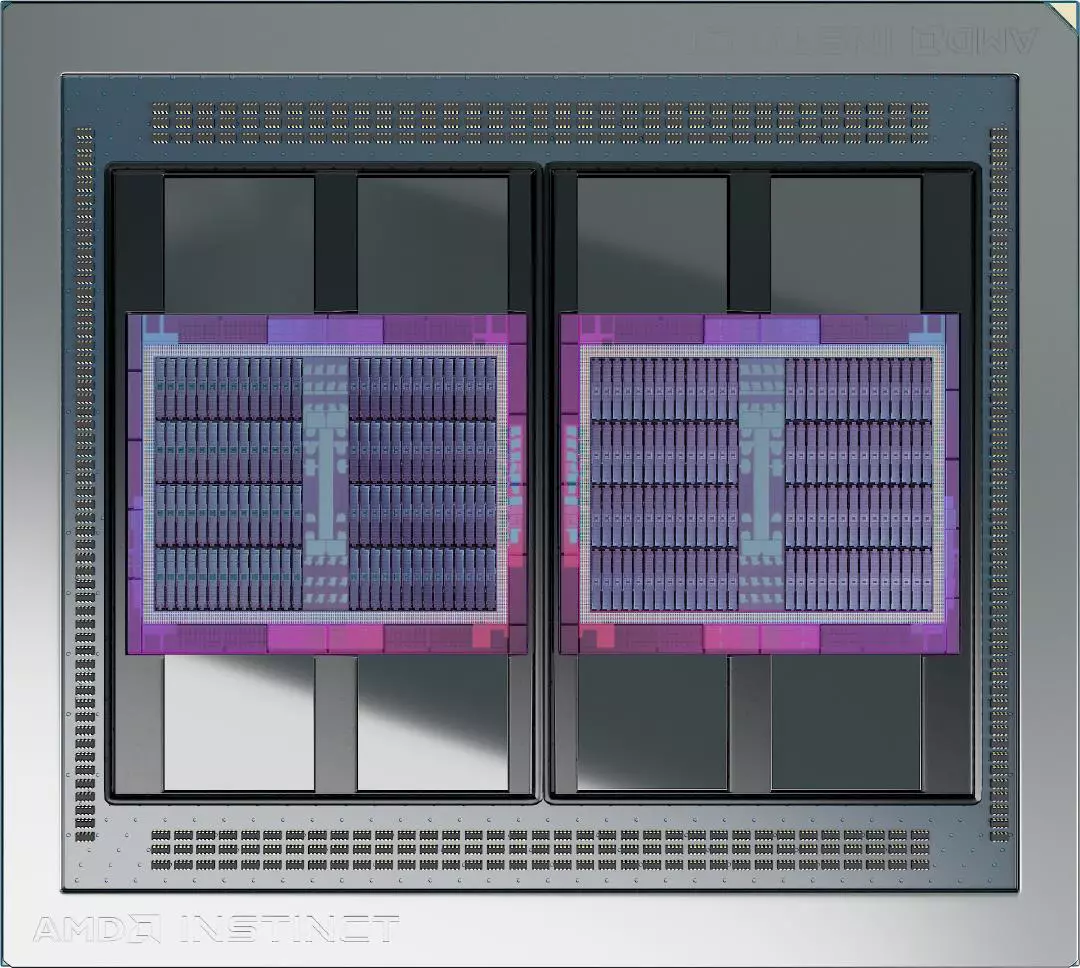
Az MI250 ehhez képest már csak 208, vagyis lapkánként 104 darab aktív CU tömböt foghat munkára, a boost órajel azonban továbbra is 1,7 GHz maradt, így összességében 5% körüli teljesítménycsökkenést szenved el ez a modell a nagytesóhoz képest. Igazából nem is ez, vagyis nem a CU tömbök száma a mérvadó, ha a két termék közötti legfontosabb különbséget keressük: az MI250 mindössze 6 darab Infinity Fabric linket kapott, míg az MI250X esetében ez a szám 8. Azok a megrendelők, akik a legnagyobb chipek közötti adatátviteli sávszélességre és maximális koherenciára vágynak, az MI250X modell felé orientálódnak majd.
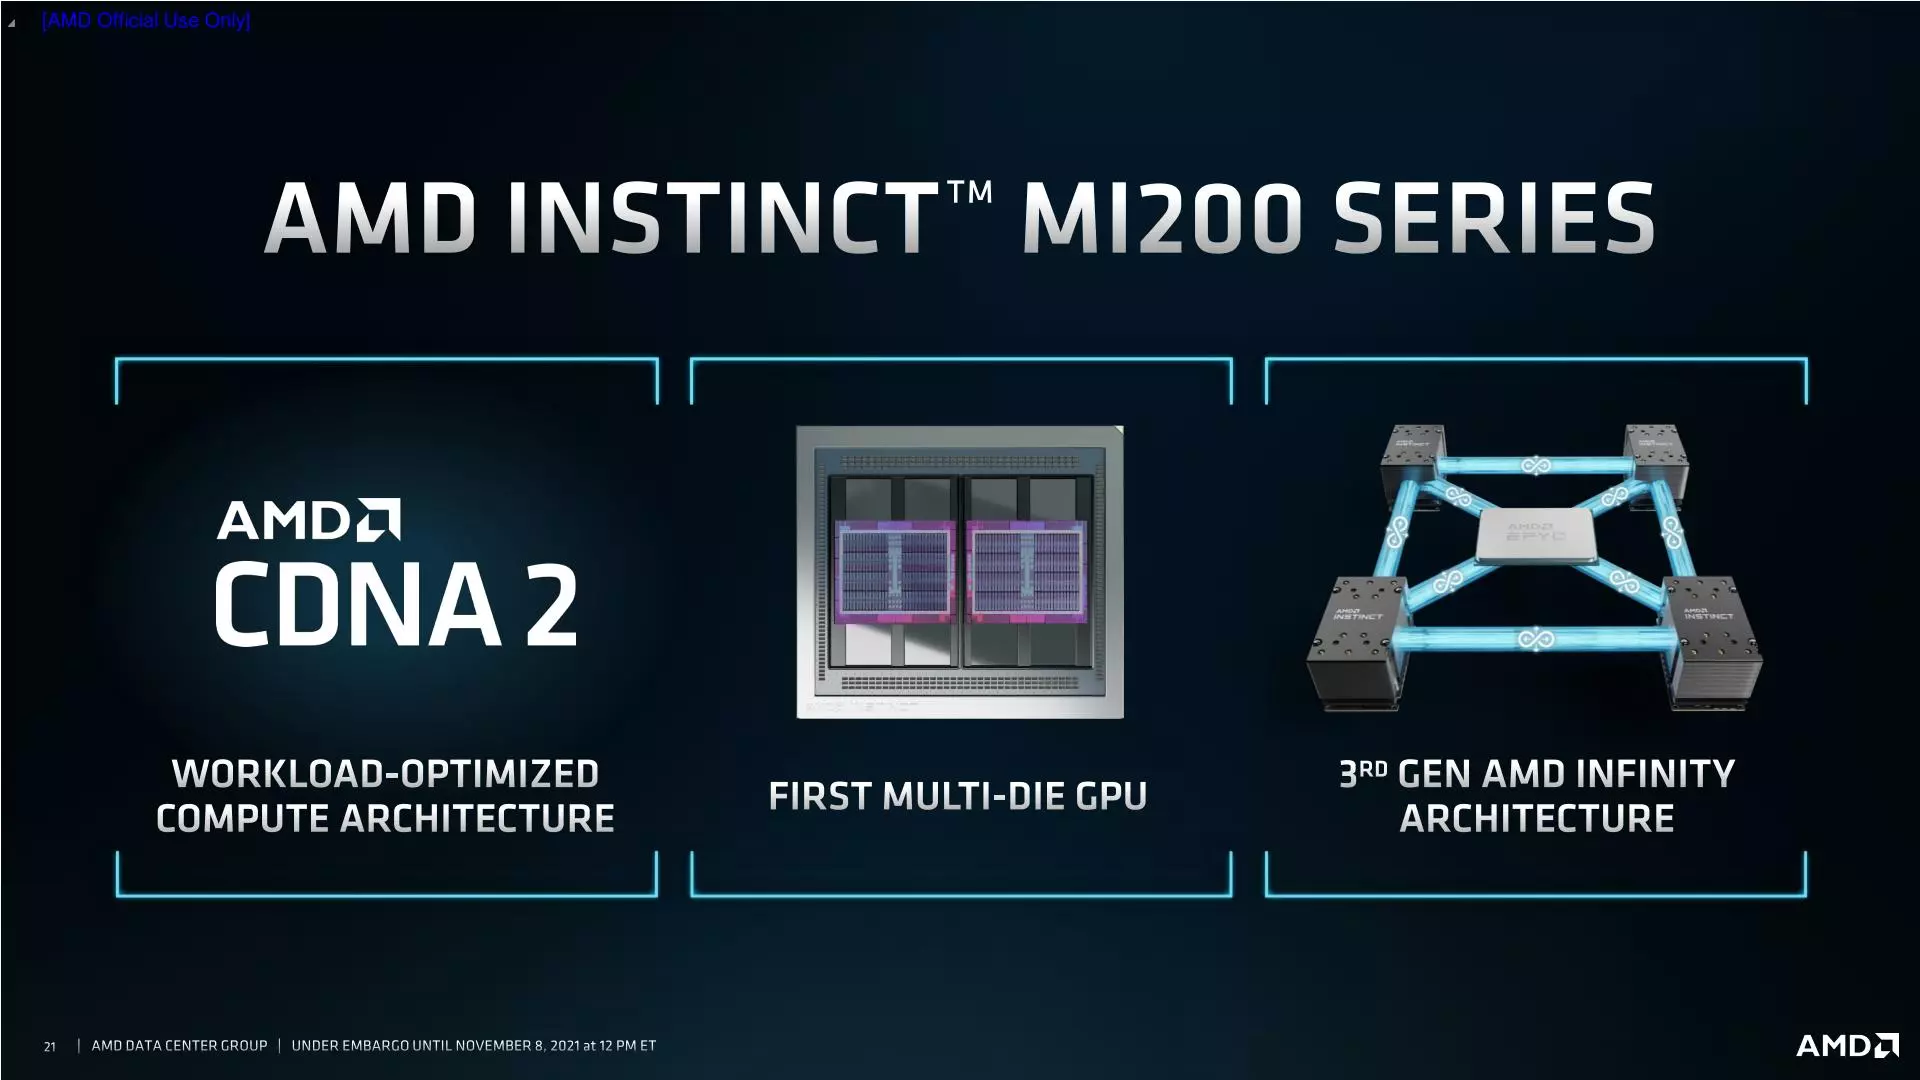
Az új lapkák a CDNA 2.0 architektúra köré épülnek, amely az MI100-as sorozatnál alkalmazott CDNA 1.0-s megoldásokhoz képest már nem felezett, hanem teljes sebességet biztosít az FP64-es műveletek számára, éppen ezért az FP64-es számítási teljesítmény itt pont a duplája annak, amit az MI100-as sorozatnál megszokhattunk.
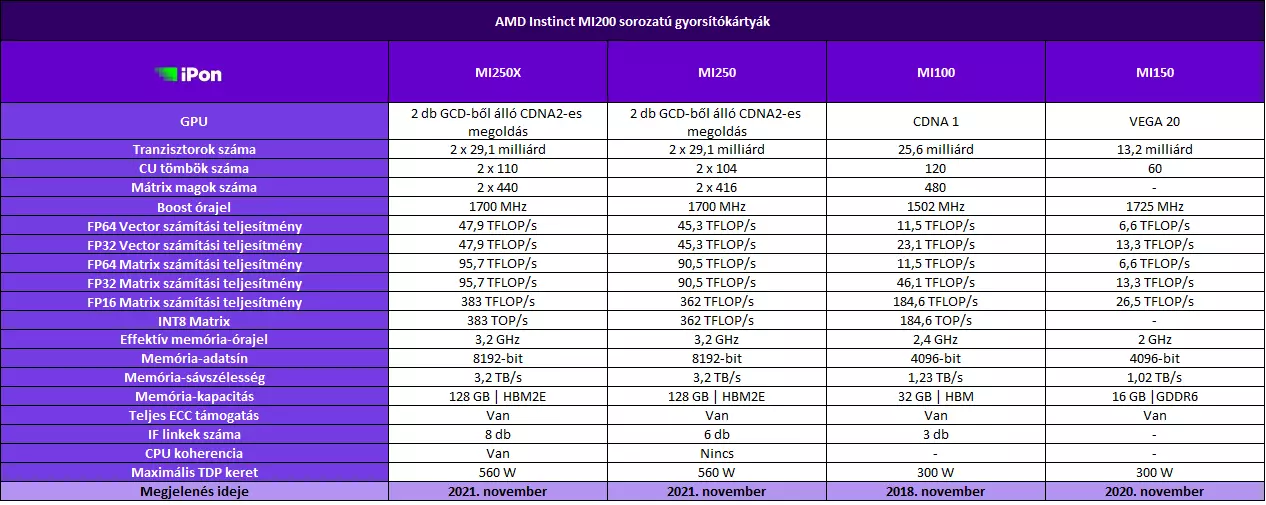
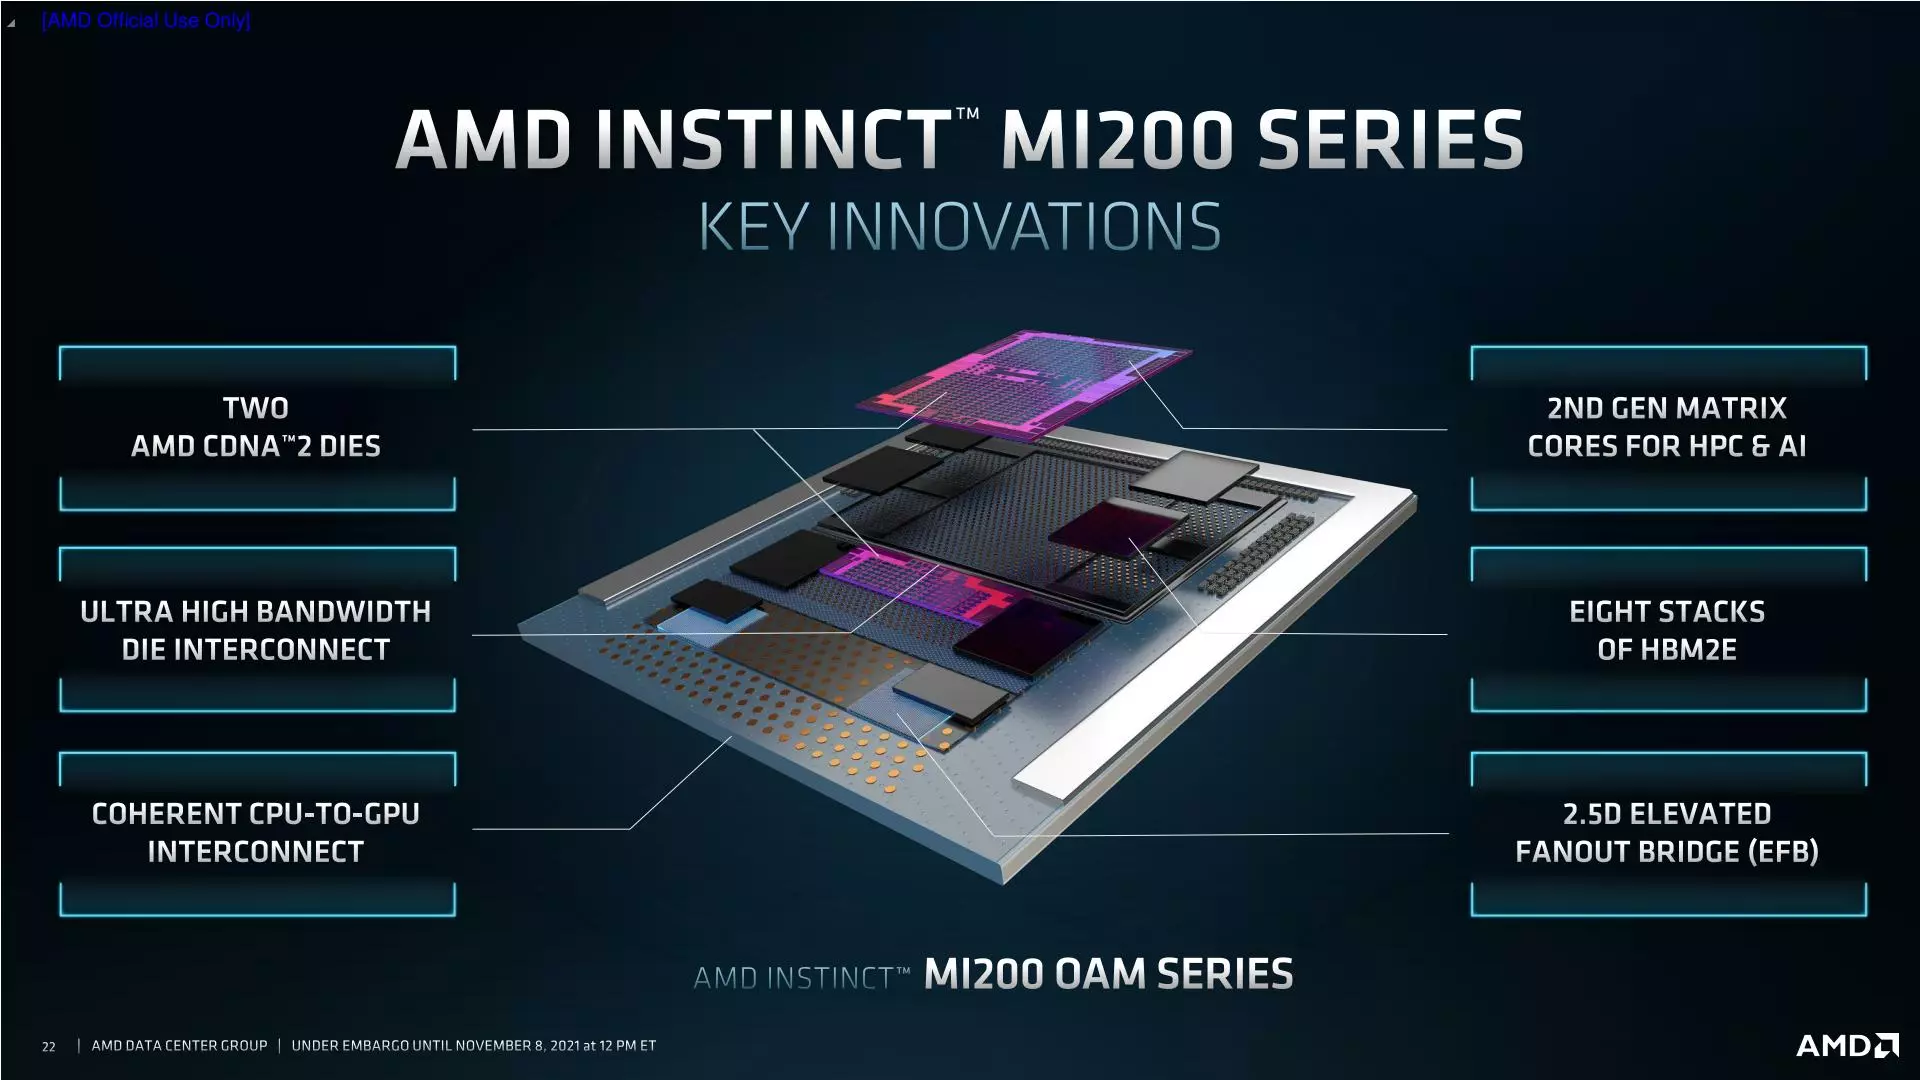
Az új gyorsítókártyák fedélzeti memória terén ugyanazt kínálják, vagyis nyolc darab HBM2E lapkaszendvicset vonultatnak fel, amelyek 3,2 GHz-es effektív órajelen ketyegnek. Egy-egy lapkára ennek megfelelően négy memórialapka-szendvics jut, amelyek egyenként 1,64 TB/s-os memória-sávszélességgel dolgozhatnak, és természetesen ECC támogatás is jelen van a kínálatban.
Az egyes HBM2E memórialapka-szendvicsek egyébként 16 GB-os kapacitással bírnak, így egy-egy lapkára 64 GB-nyi fedélzeti memória jut, azaz a teljes memória-kapacitás 128 GB mindkét modellnél.
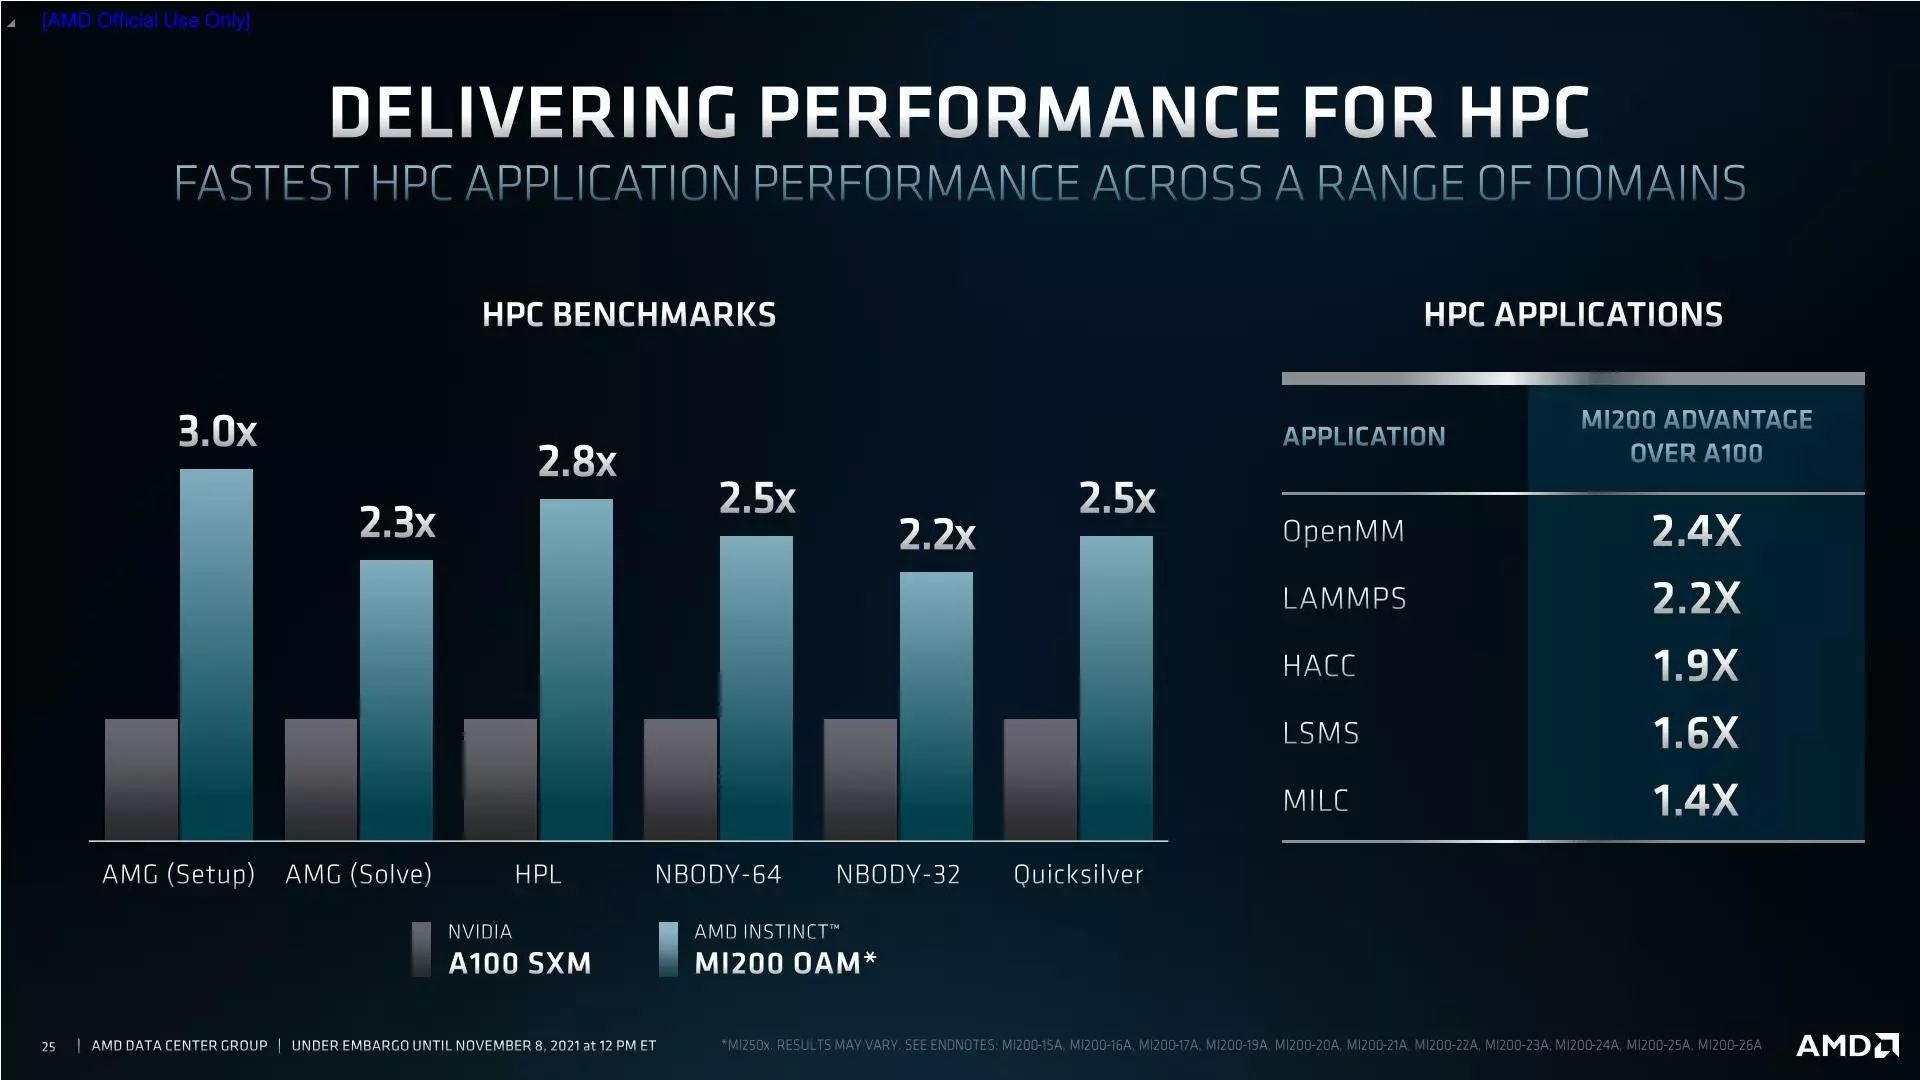
TDP keret tekintetében az MI250X 560 W-ig merészkedhet el, amennyiben folyadék alapú hűtéssel dolgozhat, ellenkező esetben 500 W a limit. Ha azt vesszük, hogy olyan nyolcutas rendszerek is készülhetnek, amelyekben nyolc ilyen gyorsítókártya foglal helyet, akkor csak ezek 5000 W-os TDP kerettel rendelkezhetnek és akkor a szerver többi komponensét még nem tartalmazza a számítás.
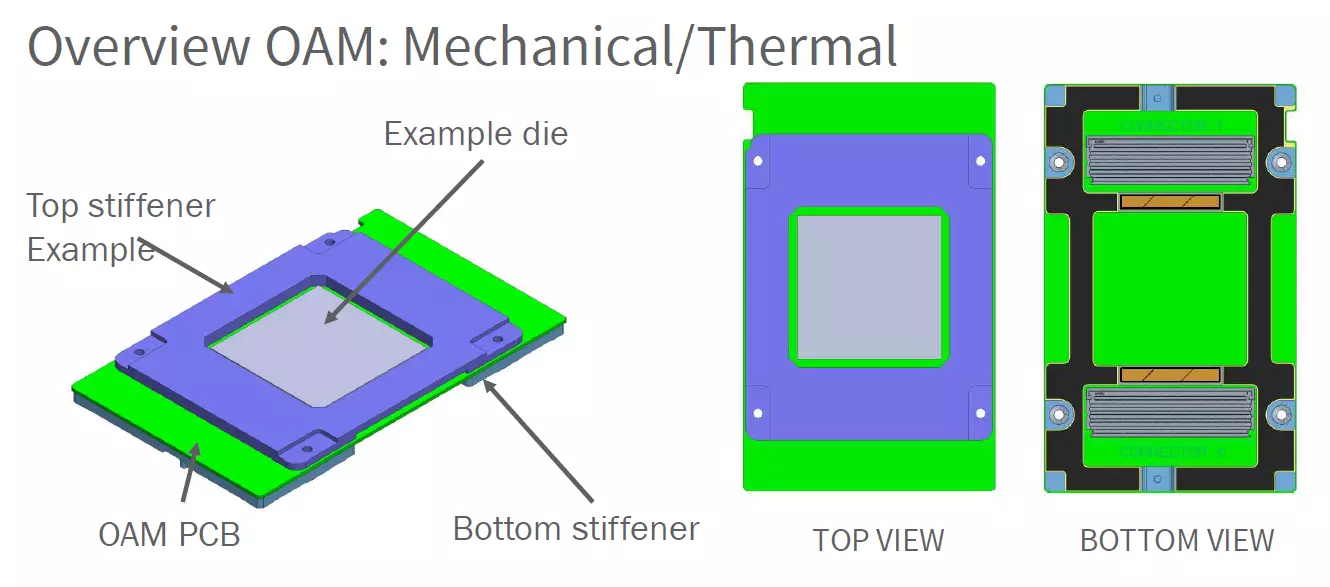
Érdekesség egyébként, hogy ezek a gyorsítókártyák OAM, azaz OCP Accelerator Module formátumban érkeznek, ami az AMD terveinek teljesüléséhez feltétlenül szükséges, hiszem az OAM sokkal több lehetőséget kínál, mint egy klasszikus kétslotos PCI Express kártya. Az OAM esetében akár nyolc darab 16-bites link is rendelkezésre állhat, míg a PCIe formátum esetében ez az érték négy. Az OAM kulcsfontosságú a CPU-GPU koherencia biztosítása szempontjából is, ugyanis e komponensek között nagy sebességű Infinity Fabric teremthet kapcsolatot.
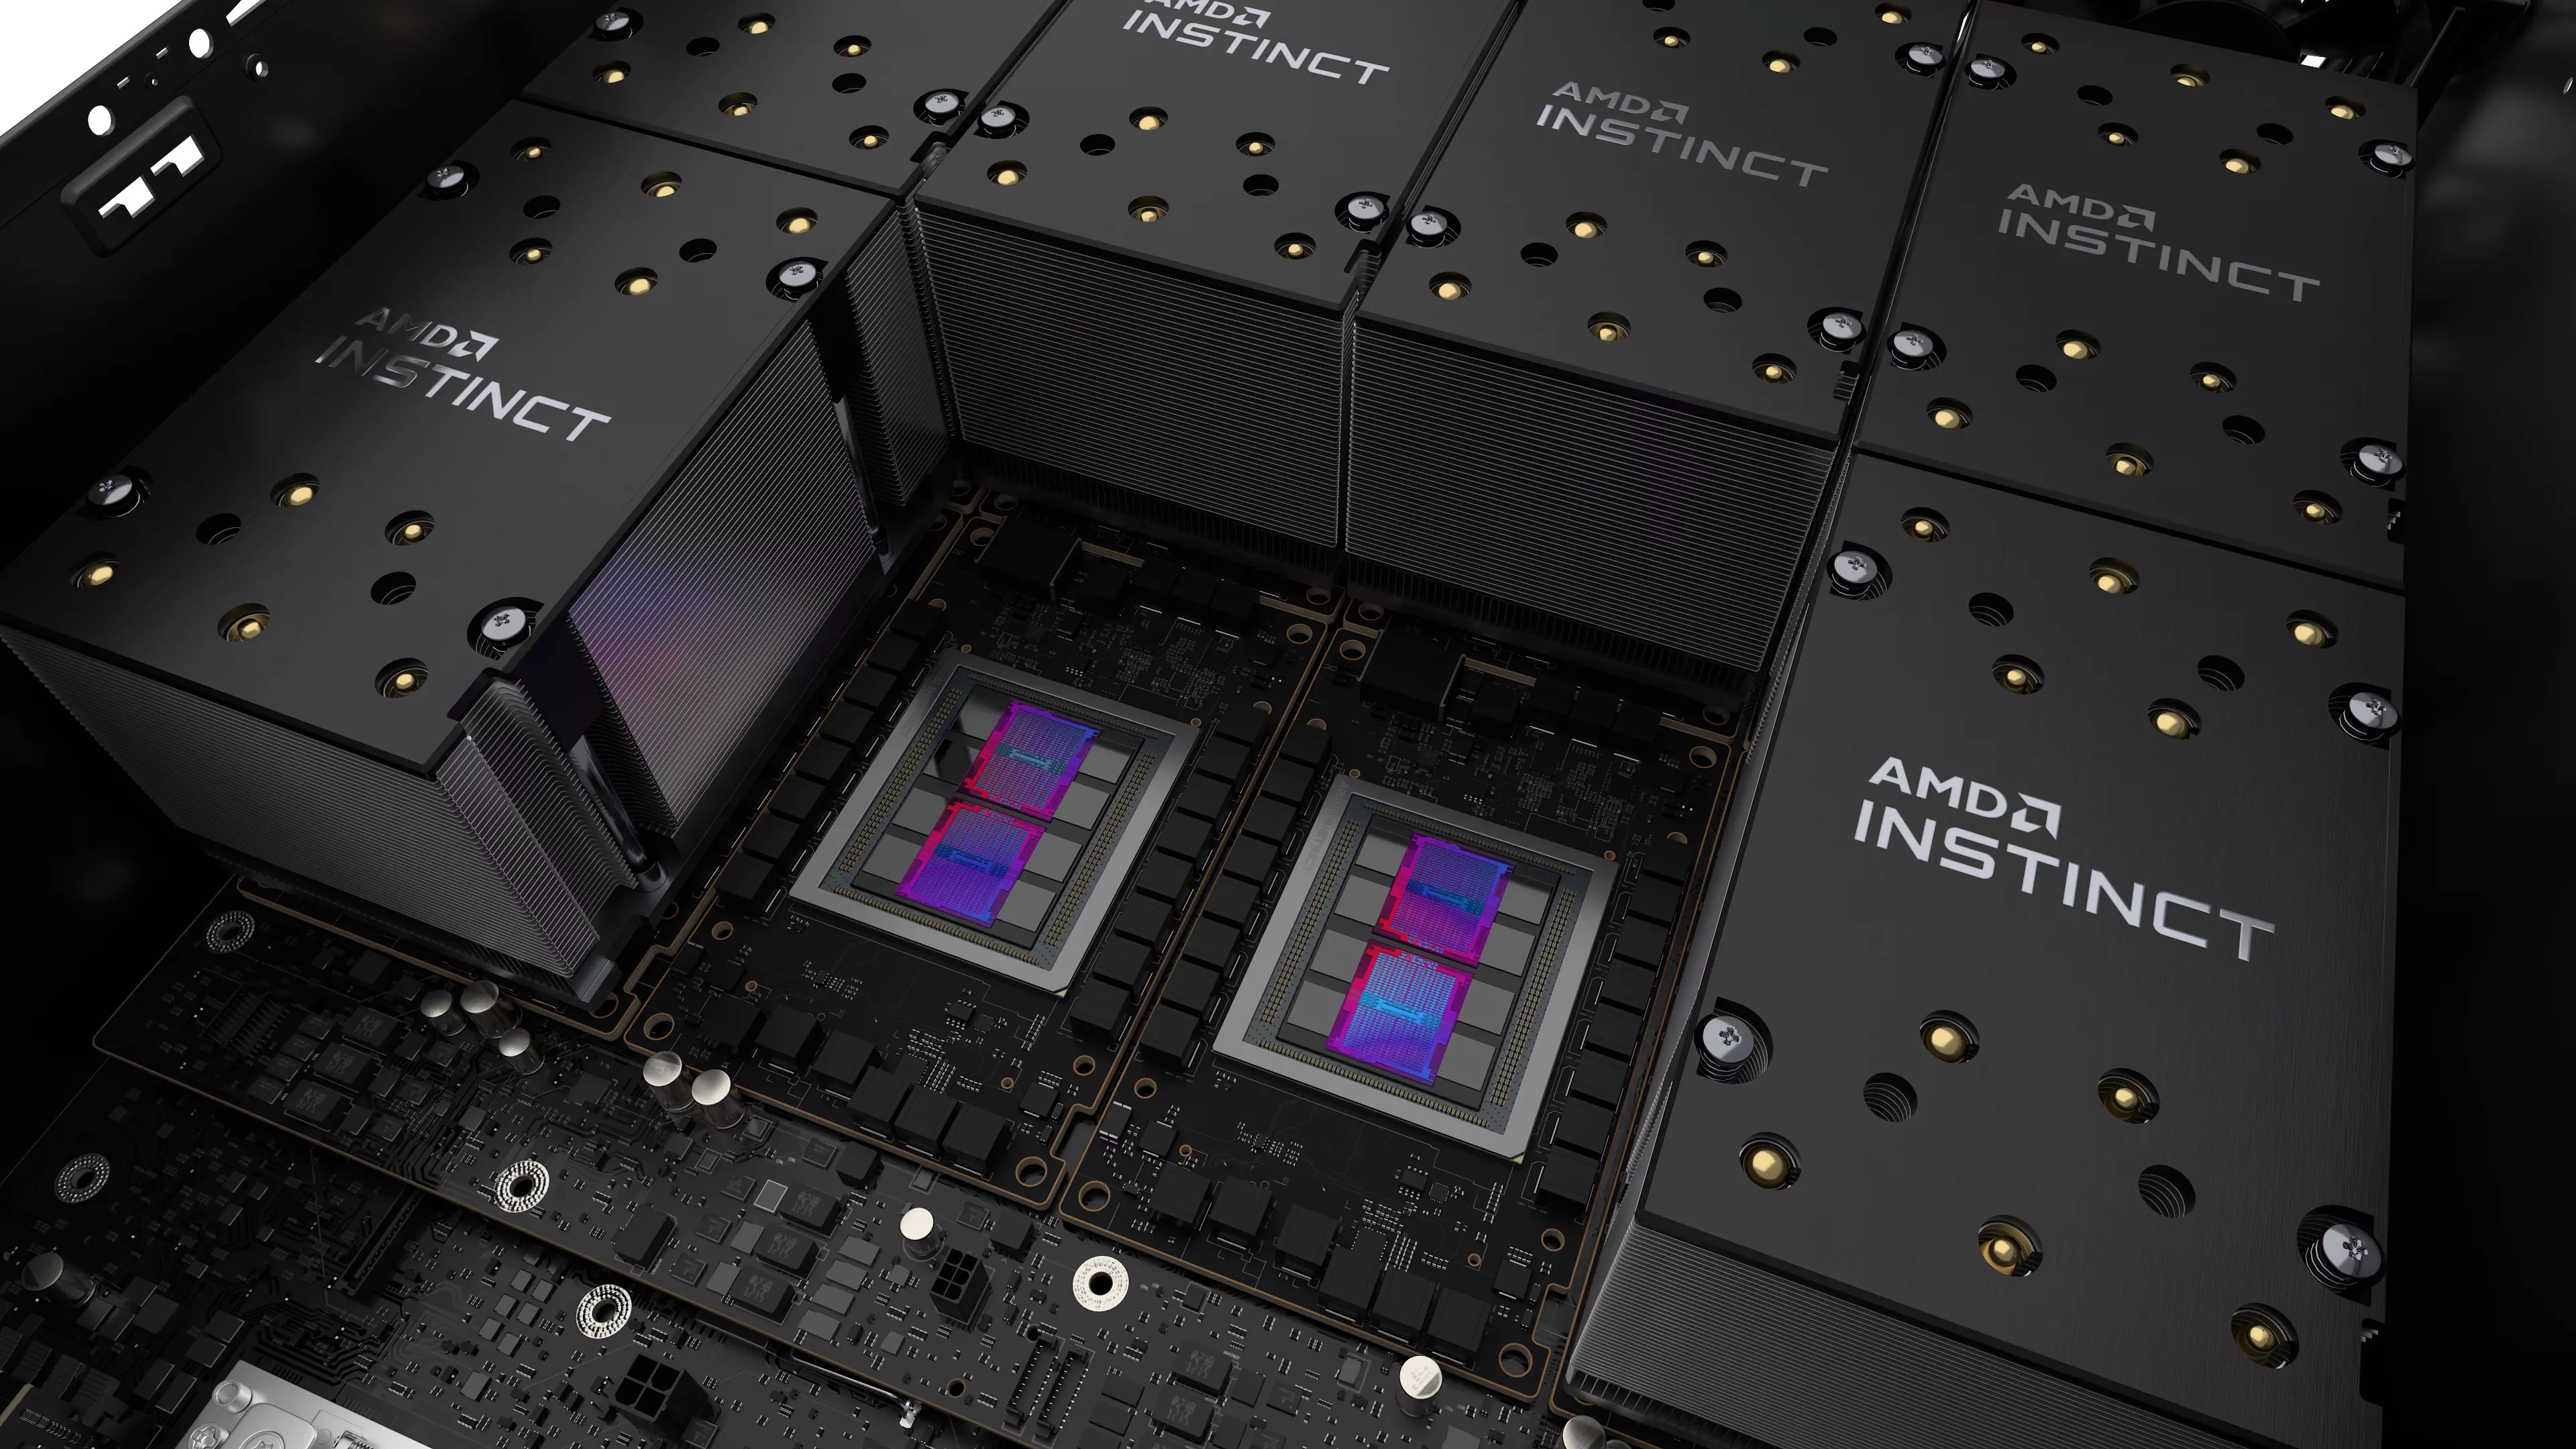
Az AMD éppen ezért az egyes GPU lapkákat (GCD) darabonként 8 Infinity Fabric 3.0-s linkkel látta el, amelyek közül 4-4 a két lapka közötti kommunikációt biztosítja, míg a másik 4-4 az egyéb eszközökkel való kommunikációért felel. Egy-egy ilyen link segítségével 50 GB/s-os kapcsolat biztosítható oda és 05 GB/s-os vissza is, azaz a két GPU lapka között 200 GB/s-os kapcsolat húzódik irányonként, ám ez még mindig töredéke annak, ami a GCD és a HBM2E memória között elérhető (1,6 TB/s).
Az MI200-as sorozat elsőként a Frontier szuperszámítógép-fürtben lesz elérhető, később azonban a többi partner is elérheti, valamikor 2022 első negyedévében.
























