




Az Anthropic folyamatosan igyekszik versenyben maradni a Google és az OpenAI mellett. A vállalat most éppen a GPT-5.4-re válaszul előrukkolt a Claude modellcsalád új zászlóshajójával, az Opus 4.7 modellel. Közben a cég elindította a Claude Mythos előzetesét is, de az teljesen más célt szolgál.
A Claude Opus 4.7 értelemszerűen az Opus 4.6 helyét veszi át a palettán, ami már eleve egy széles körben használt és kedvelt modell volt. Nagyon erősnek bizonyult a fejlett programozási kihívásokban és a komplex MI ágensi kihívásokban, feladatok egymást követő végrehajtásában. Az újdonság is hasonló területeken fog remekelni. “Az Opus 4.7 jelentős fejlődést hoz az Opus 4.6-hoz képest a fejlett szoftverfejlesztés terén, különösen a legnehezebb feladatok megoldásában.” – emelte ki a vállalat.
Az Anthropic szakemberei sikeresen tudták azt elérni, hogy a Claude Opus 4.7 szigorúan és konzisztensen hajtson végre összetett és kifejezetten hosszú feladatokat. Kiemelkedően nagy figyelmet szentel a precizitásra az instrukciók betartása, követése során. Minden korábbinál erőteljesebb beépített ellenőrző mechanizmussal dolgozik, és az eredményeket azt követően fogja feltárni, hogy mindent újra “áttekintett”. Ennek köszönhetően kevésbé lesz szükség az extra felügyeletre.
Fontos újítása a Claude Opus 4.7-nek, hogy a multimodális működés terén komoly fejlődést hoz a gépi látásban. Nagyobb felbontásban lesz képes feldolgozni a bevitt képeket (3,75 MPixel). Az Anthropic kitért arra is, hogy kreatívabb és ízlésesebb lesz a Claude az új modell révén. Magas minőségű interfészeket lesz képes létrehozni professzionális megbízatások alkalmával. Látványosabb diákat kreálhat majd az Opus 4.7 a felmenőinél, és a dokumentumok létrehozása során is jelentősebb figyelmet szentel majd a formázásra.
Jelentős fejlődést mutat majd a pénzügyekben, jogi feladatokban, vállalati tudásbázisok kezelésében. Ezeknek köszönhetően a céges felhasználási lehetőségek sokkal jobbak lesznek, több vállalati partnerre tehet majd szert az Anthropic. A cégnek egyébként sem az általános fogyasztók között van igazán széles tábora, így nem meglepő, hogy most sem a hétköznapi feladatokban igyekszik erősíteni. Jobban lehet majd használni a Claude Opus 4.7-et pénzügyi ágens feladatokra is. A Finance Agent v1.1 tesztben 64,4%-ot ért el, míg a GPT-5,4 61,5%-ot, a Gemini 3.1 Pro 59,6%-ot hozott össze.
Az SWE-Bench Pro tesztben a programozó “ügynöki” képességeivel 64,3%-os eredményt hozott össze a Claude Opus 4.7, miközben a Google jelenlegi legjobb publikus modellje, a Gemini 3.1 Pro csak 54,2 százalékot tudott produkálni, és a GPT-5.4 sem vizsgázott sokkal jobban, 57,7%-ot ért el. A felkapott Humanity’s Last Exam keretében kiegészítők nélkül 46,9%-os eredménnyel büszkélkedhet, mivel a Gemini 3.1 Pro csak 44,4%-ra volt képes ezúttal, a GPT-5.4 pedig mindössze 42,7 százalékot hozott össze.
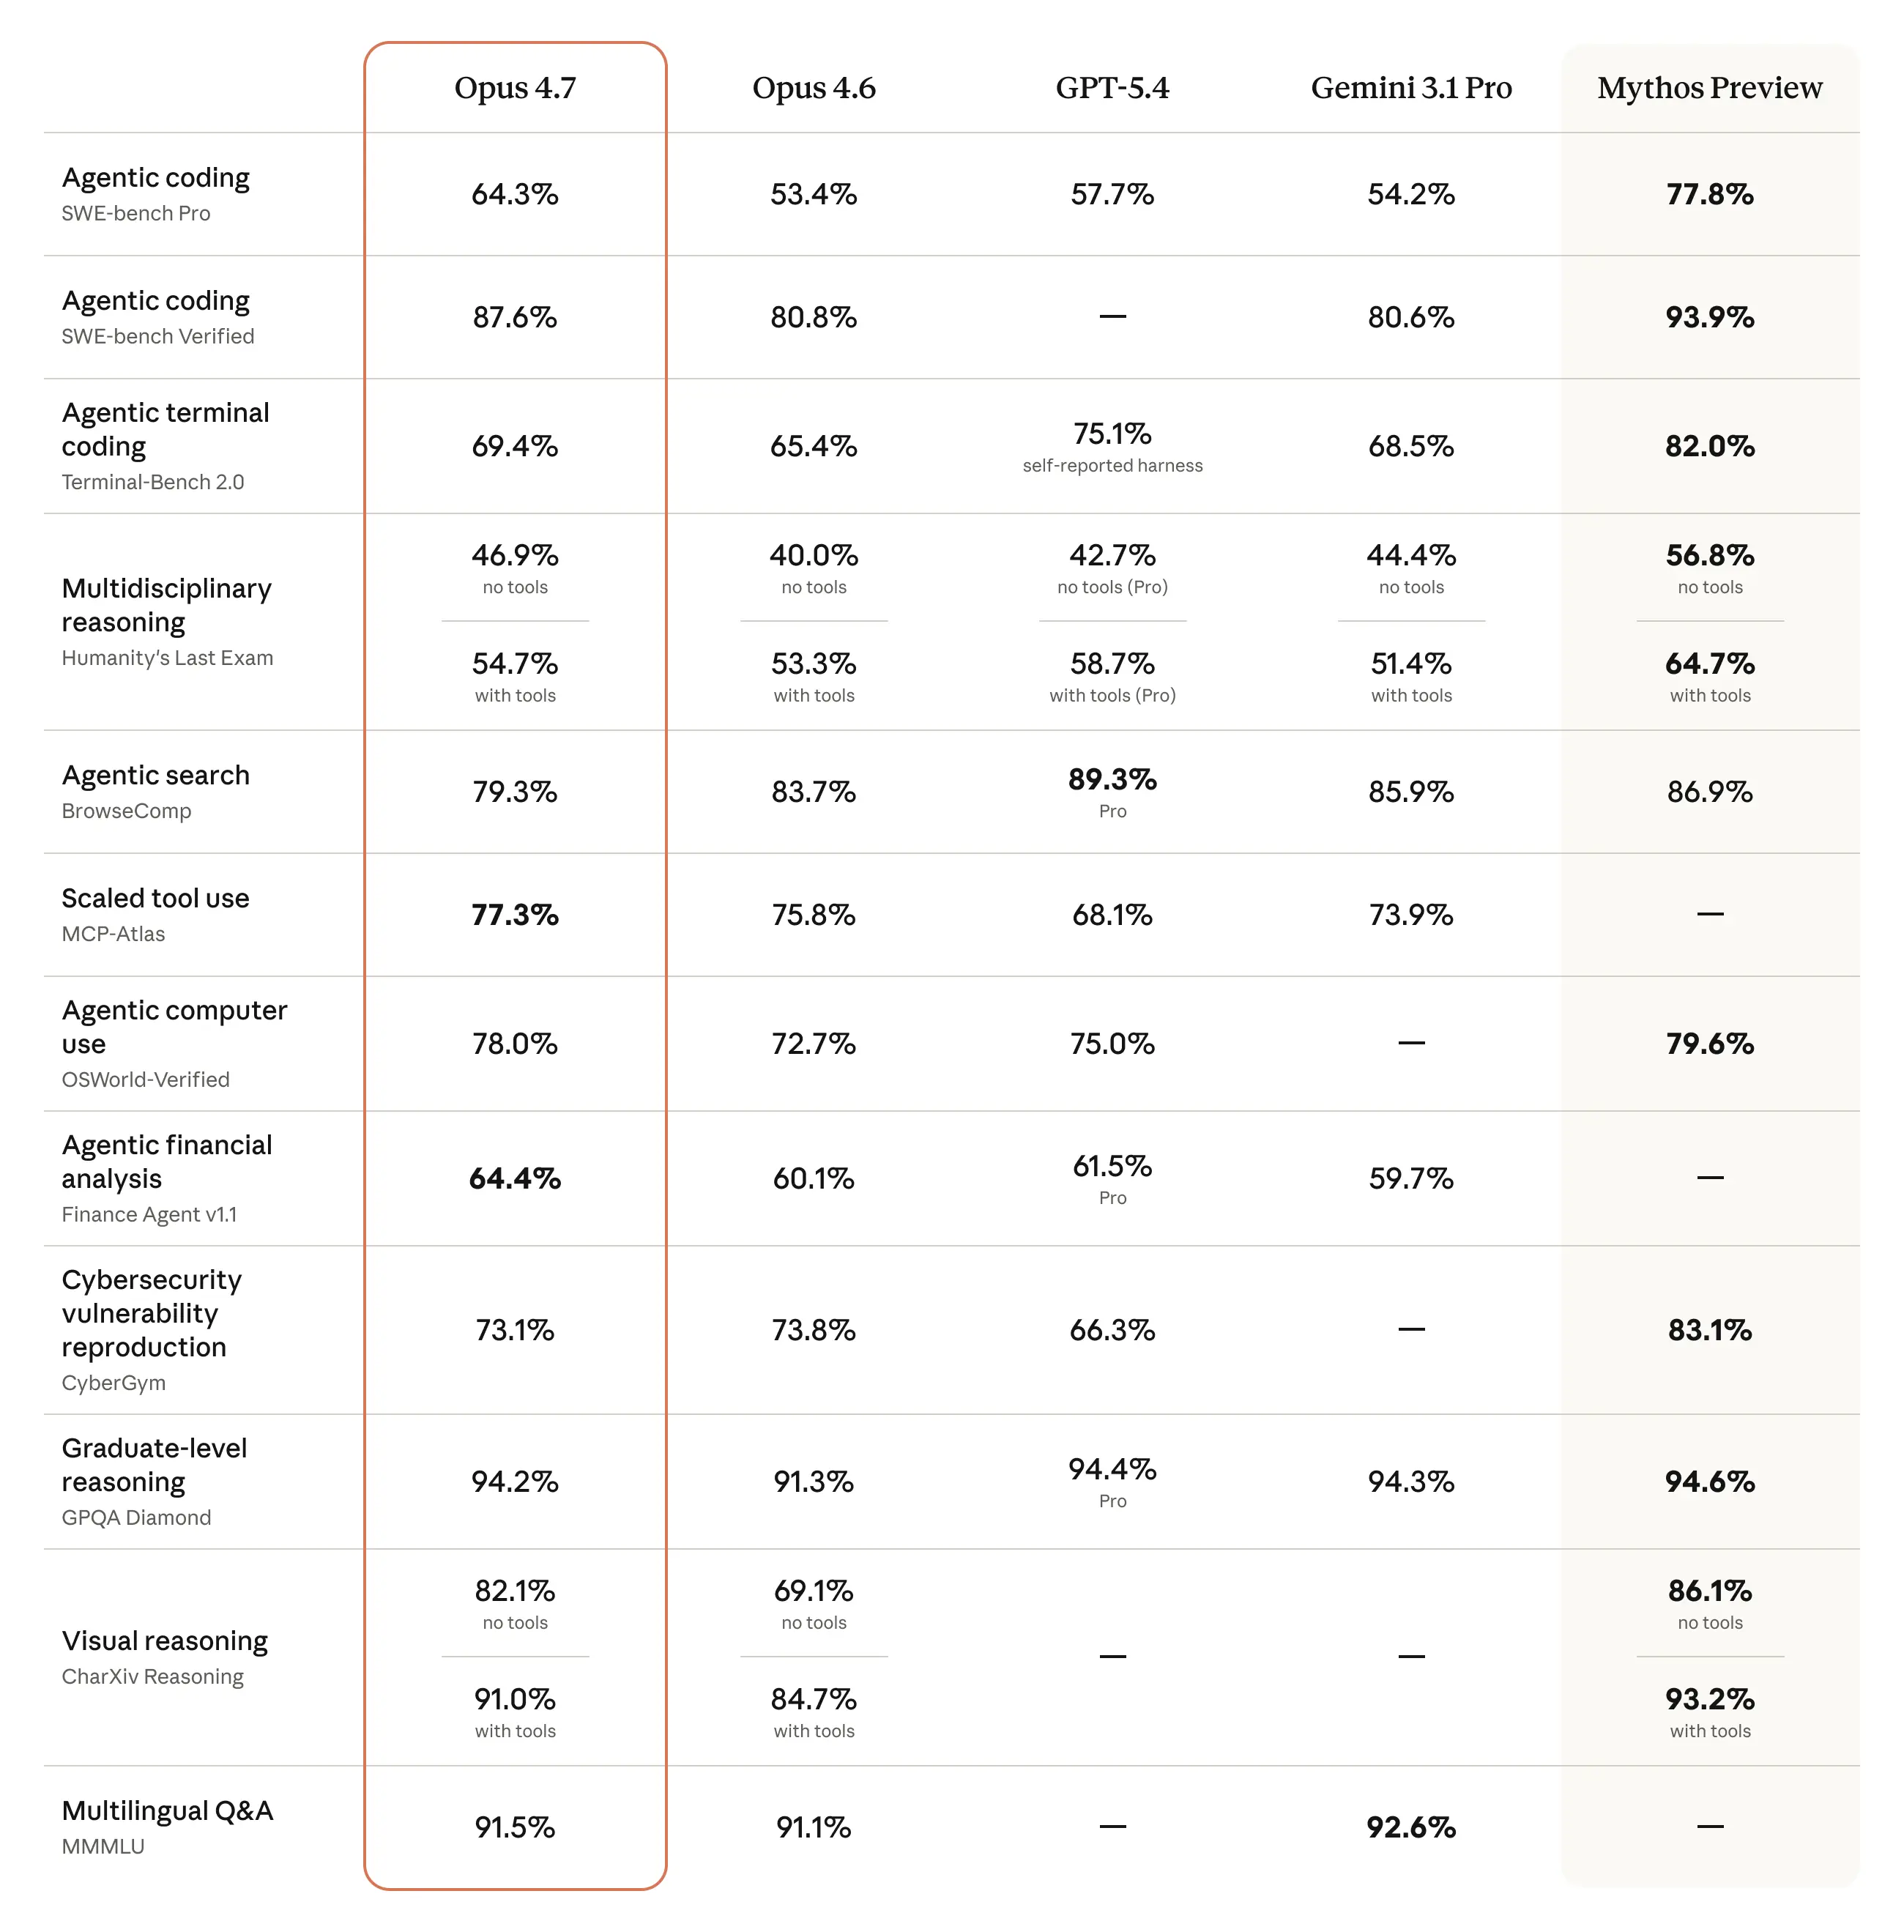
A cég a modellek teljesítményének összevetésébe beemelte a fentebb említett Claude Mythos előzetesét is, ami igazából mindenben jobbnak tűnik. Ez az Anthropic részéről csak erődemonstráció és reklám, mert azt látni kell, hogy a Mythost csak egy nagyon szűk partneri körnek biztosítja egyelőre, és a biztonság javítására szolgáló projektben alkalmazza. Az ára pedig sokkal magasabb, mint bármilyen széles körben elérhető nyelvi modellnek.
A Claude Opus 4.7 most indul a Claude applikációban, hozzáférhető lett a Claude API-ban, és biztosítja ezt a partnerek számára az Amazon, a Google és a Microsoft is a különböző felületein keresztül. Itt a feldolgozás 1 millió token esetén 5 dollárba kerül, a kimeneti oldalon pedig ugyancsak 1 millió token 25 dollárt kóstál (a Claude Mythos ötször költségesebb).