
A 2026-os év vége nagyon mozgalmas lesz az Anthropic számára. A vállalat a napokban szinte egyszerre indította el a Claude 5.5 család két tagját, a Sonnet és a Haiku változatokat, de ez most a kevésbé fontos kihívás előtte, hiszen éppen az IPO-ra készül. A hírek szerint novemberben a tőzsdére léphet az MI-szektor nagyágyúja.
A Claude égisze alatt innentől a mély, elemzői érvelésekre és összetett döntéshozatalra szolgáló Claude Opus 5.5 már elérhető lesz a mindennapi fejlesztői és irodai munkára szánt Claude Sonnet 5.5, valamint a széles tömegeknek szánt, gyors és alacsony költségek mellett dolgozó Claude Haiku 5.5 is. Az új modellek látványos áttörést hoznak a hatékonyságban, a programozási képességekben, és erős kihívóként szállnak ringbe a GPT-6 modellek ellen.
A Sonnet 5.5 a Sonnet 5-höz képest javulást mutat a teljesítmény, a kódolás, a tudásalapú munka, a hosszú távú ügynöki feladatok, a képértelmezés, a kollaboráció, a sebesség és a hatékonyság terén. A Haiku 5.5 a legjobb a rövid és ismétlődő feladatok elvégzésére, mint például összefoglalások, tömörítések, adatbázis-lekérdezések és osztályozási feladatok. Emellett a Claude Opus 5.5 és a Claude Sonnet 5.5 alatt ügynökként működhet kódolási feladatok elvégzésére.
A Claude Haiku 5.5 az első Haiku-osztályú modell, amely már kellően erős ahhoz, hogy finomhangolható legyen. Ez lehetővé teszi a felhasználók számára, hogy az igényeiknek megfelelően egyensúlyozzon a modell a legalacsonyabb költségek és a magasabb tudásszint között.
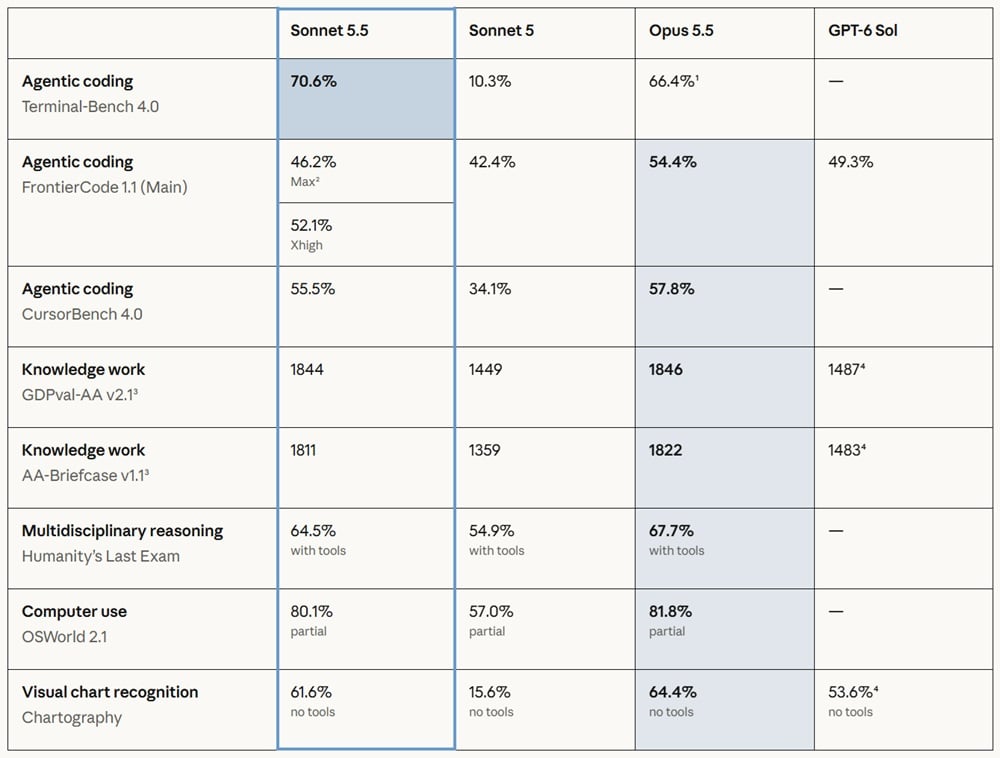
A Sonnet 5.5-nél már nem új, hogy különböző szinteken működhet, így mindig a legoptimálisabb érvelési szintre hangolódik. Több teszt szerint a Sonnet 5.5 max már az Opus 5.5-höz hasonló teljesítményt nyújt, a gyorsabb és hatékonyabb beállításokban pedig felülmúlja a Sonnet 5-öt, miközben a költsége akár a tizede lehet.
A Claude Sonnet 5.5 olyan jól el lett találva, hogy szélsőséges esetben akár még az is megeshet, hogy az Opus 5.5-nél jobbnak bizonyul, miközben fele költségből üzemel.
A Terminal-Bench 4.0-ban például 70,6%-os eredményt tudott elérni a Sonnet 5.5, miközben a nagyobb modell 66,4%-on teljesített. A GDPval-AA 2.1 keretében már elmarad az Opustól, de csak egy hajszállal, hiszen 1844 pontot ért el az 1846 ponz ellenében, a GPT-6 Sol pedig ebben csak 1487 pontra képes. Az ügynöki programozási képességet néző FrontierCode 1.1 alatt beállítástól függően 46,2-52.1%-os eredményt hoz a Sonnet 5.5, az Opus 5.5 54,4%-ra képes, a GPT-6 Sol pedig 49,3%-os sikerarányt tud felmutatni.
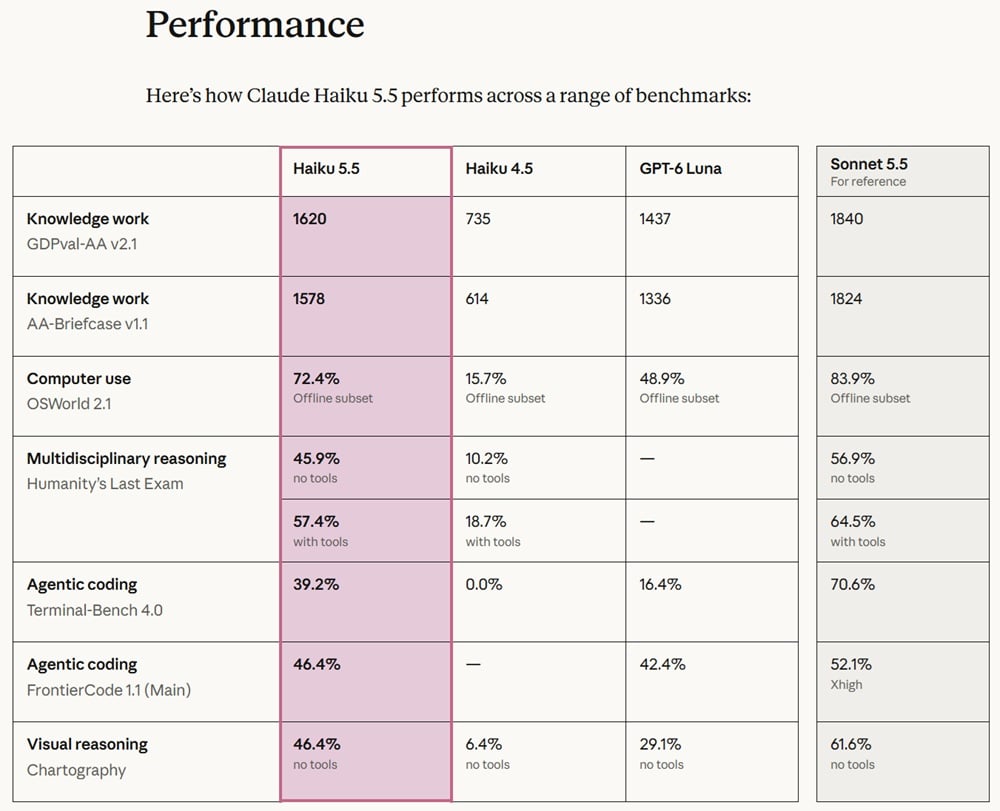
Az Anthropic által megosztott mérések szerint a Claude Haiku 5.5 a tudásalapú munkára koncentráló GDPval-AA 2.1-ben 1620 pontot képes felmutatni, amivel az OpenAI GPT-6 Sol modelljét is megelőzi, pedig a valódi ellenfele a GPT-6 Luna, mely mindössze 1437 pontot tudott ebben elérni. A népszerű és komoly kihívást jelentő Humanity’s Last Exam tesztben 57,4%-os eredményt is képes összehozni kiegészítőket használva, amivel már megelőzi az eszközök nélkül futó Sonnet 5.5-öt (56,9%), miközben ez utóbbi akár 20-szor drágább lehet. És hasonló a helyzet a FrontierCode 1.1 tesztben is, ahol a 46,4%-os produkciójával már hozza a visszafogott Sonnet 5.5 szintjét, a GPT-6 Lunát (42,4%) pedig magabiztosan előzi.
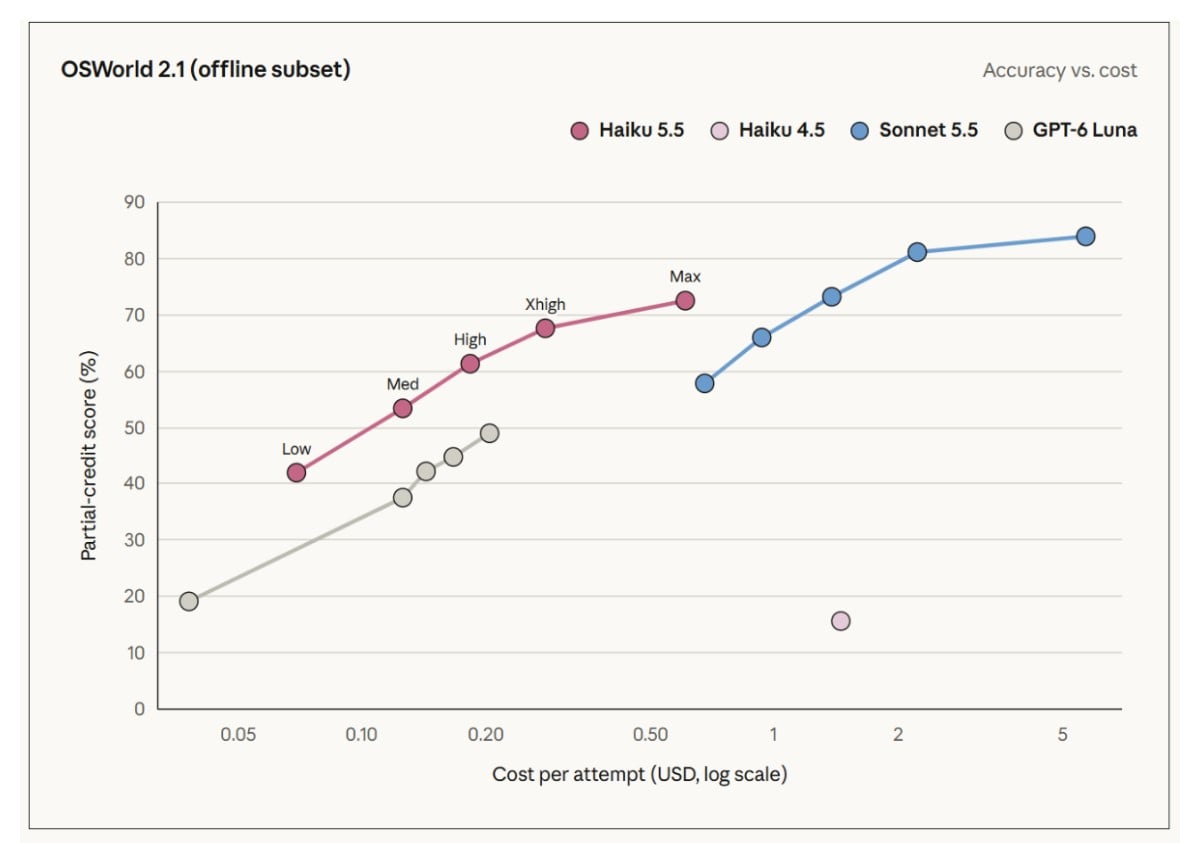
Igyekezett azt kiemelni az Anthropic, hogy a Claude 5.5 az új modellekkel elképesztően jól skálázható rendszert biztosít például a programozás terén. Ezeknek köszönhetően a vállalkozások számára egy olyan csomagot jelent, mellyel az eddiginél sokkal jobban kordában tarthatók a költségeik, jobb teljesítmények és pontosabb munka elérése mellett. A Claude Opus 5.5-nek kiadott kihívások megoldását a Sonnet 5.5 modellt használó ügynökök végezhetik a legerősebb modell felügyelete alatt, a Sonnet 5.5 pedig a kisebb részfeladatokra létrehozhat Haiku 5.5-ön futó alügynököket. A CursorBench és az OSWorld is kiemelkedő teljesítményt mért a széria mindegyik tagjánál.
A kiberbiztonság tekintetében a Haiku 5.5 szigorúbb védelmi intézkedésekkel rendelkezik, mint a Haiku 4.5, és a biológiai biztonsági intézkedéseket tekintve pedig már ugyanazon a szinten áll, mint a Sonnet és az Opus modellek. Az ágazat legjobb szakembereivel dolgozott a biztonság megerősítésén az Anthropic. A cég automatizált viselkedésvizsgálata több mint 1800 forgatókönyvet fed le, és a Sonnet 5.5 szinte mindenben komoly előrelépést jelent a Sonnet 5 modellhez képest.
Az új modellek minden platformon azonnal hozzáférhetővé váltak a felhasználók számára. A Claude Haiku 5.5 a költségeket tekintve külön elbírálás alatt kezeli a 100 000 token alatti promptokat és a nagyobb feladatokat. Ameddig 100 000 token alatt marad a feladat, addig akár 0,1 dollárból letudható 1 millió token feldolgozása egy teljes beszélgetésben, és 0,5 dollár ugyanilyen mennyiségű tartalom előállítása. Ha viszont hosszabb prompt kerül elő, akkor ezek a költségek az ötszörösére, tehát 0,5 és 2,5 dollárra emelkednek.
Ami a Claude Sonnet 5.5-öt illeti, a jobb képességű modellel 2 dollárból lehet megoldani 1 millió token feldolgozását, és 10 dollárba kerül ugyanúgy 1 millió token létrehozása. Ez tehát azért már lényegesen drágább, de azt is látni kell, hogy a teljesítményét tekintve már nagyon közel van a Claude Opus 5.5-höz, miközben azért minden fronton kétszer annyit kell fizetni, szóval a hatékonyságban nem kérdés, hogy az újabb modell a jobb választás. Készül a Claude Fable 5.5 is, de ezen még dolgozik az Anthropic, és ez lényegesen drágább lesz a szóban forgó megoldásoknál.
