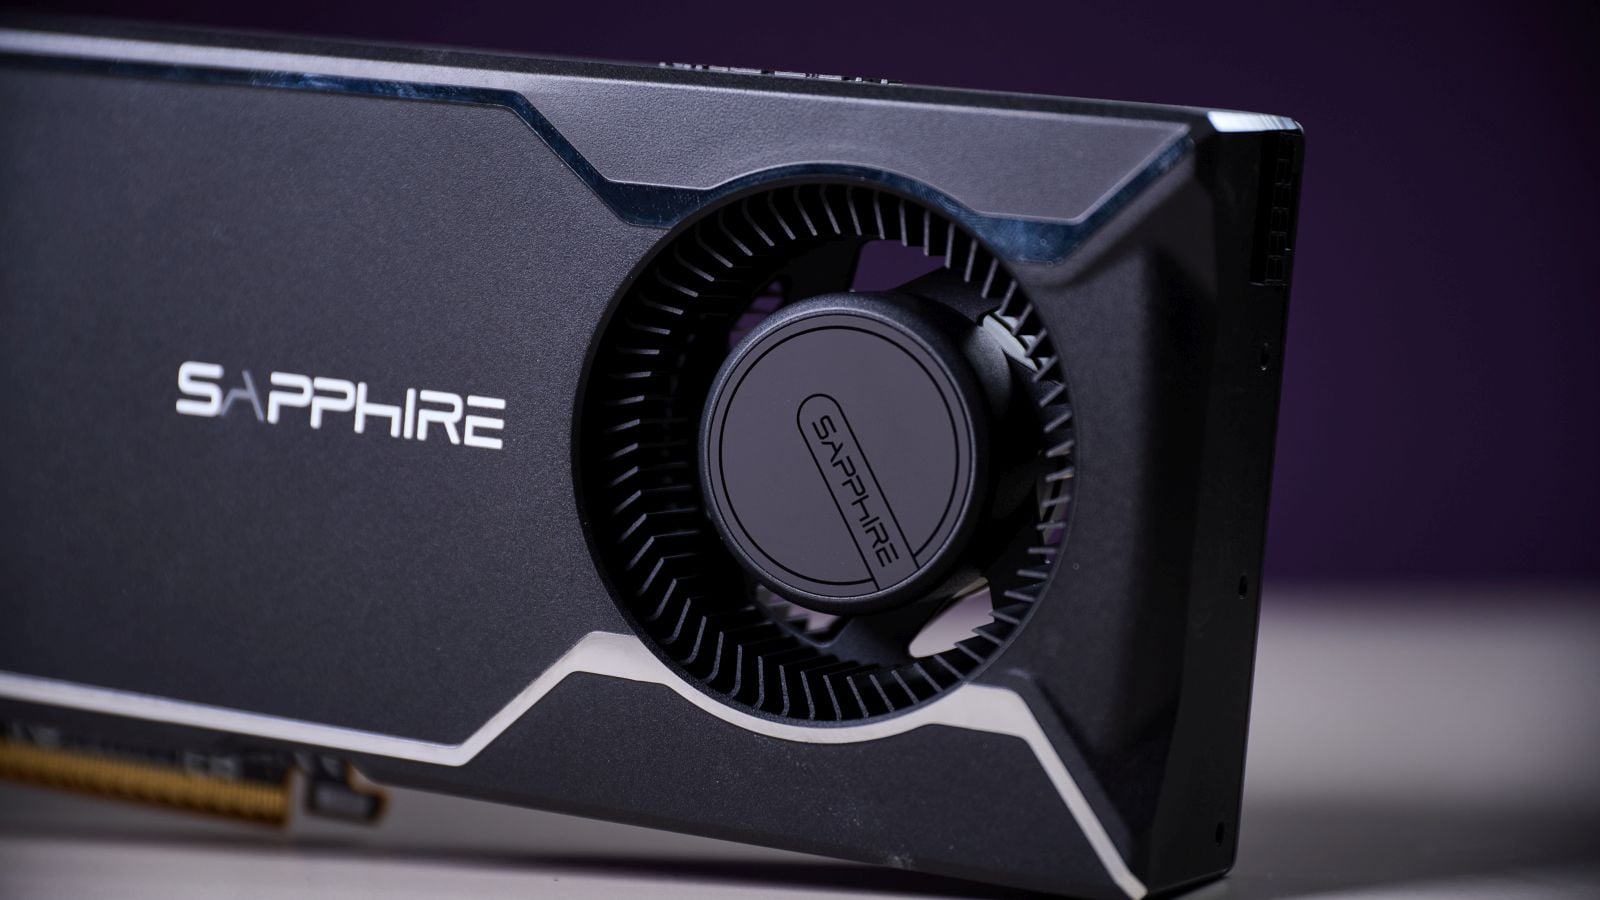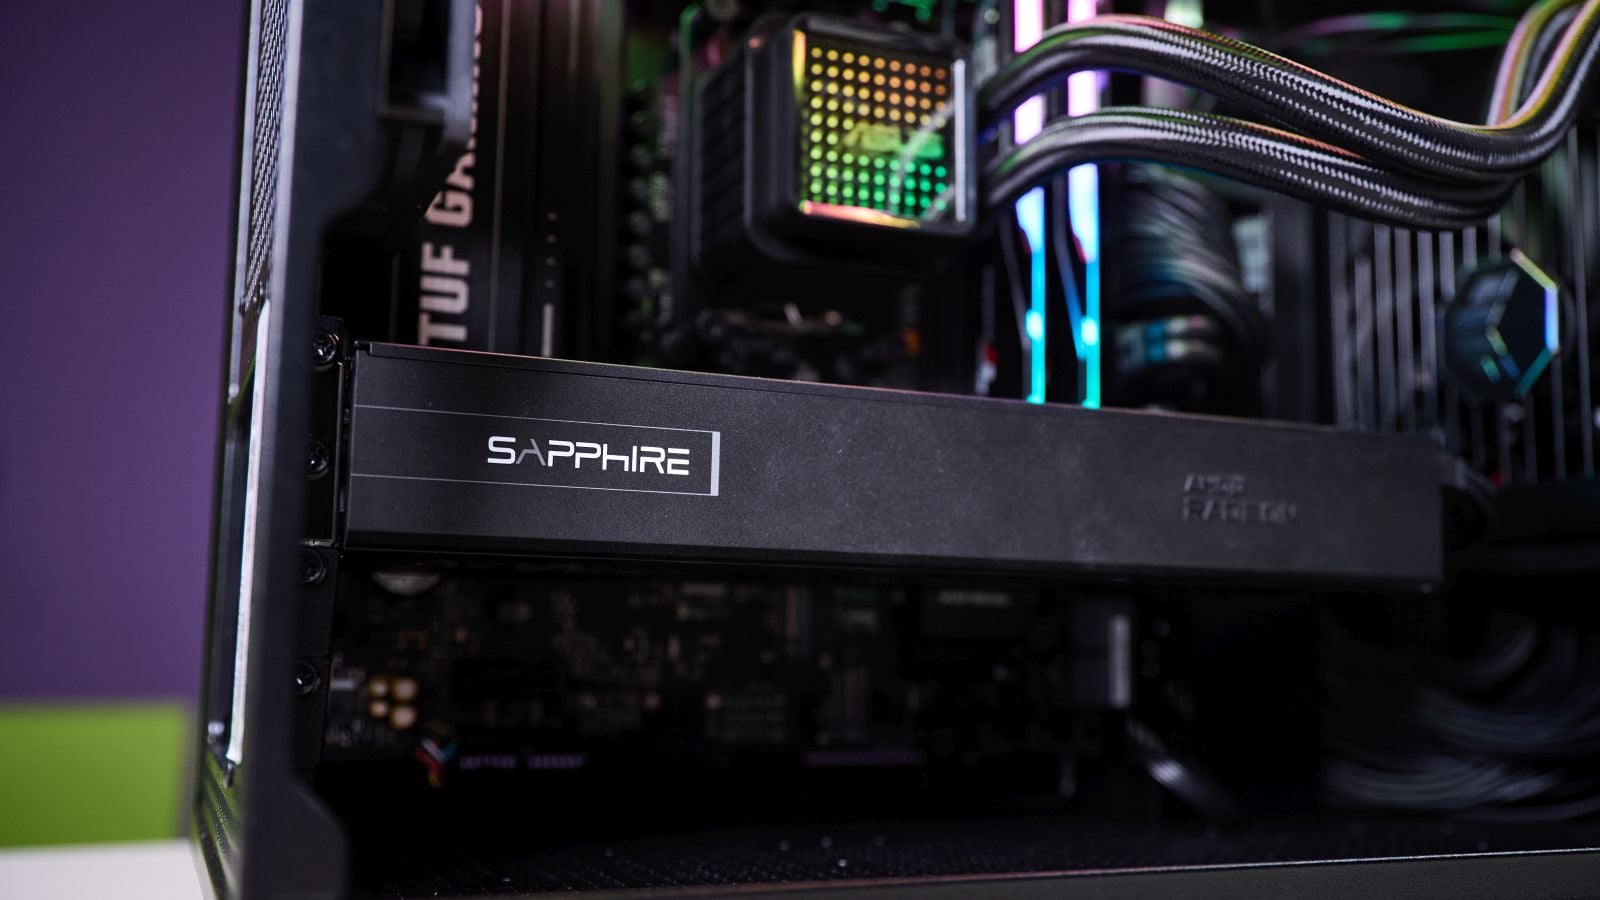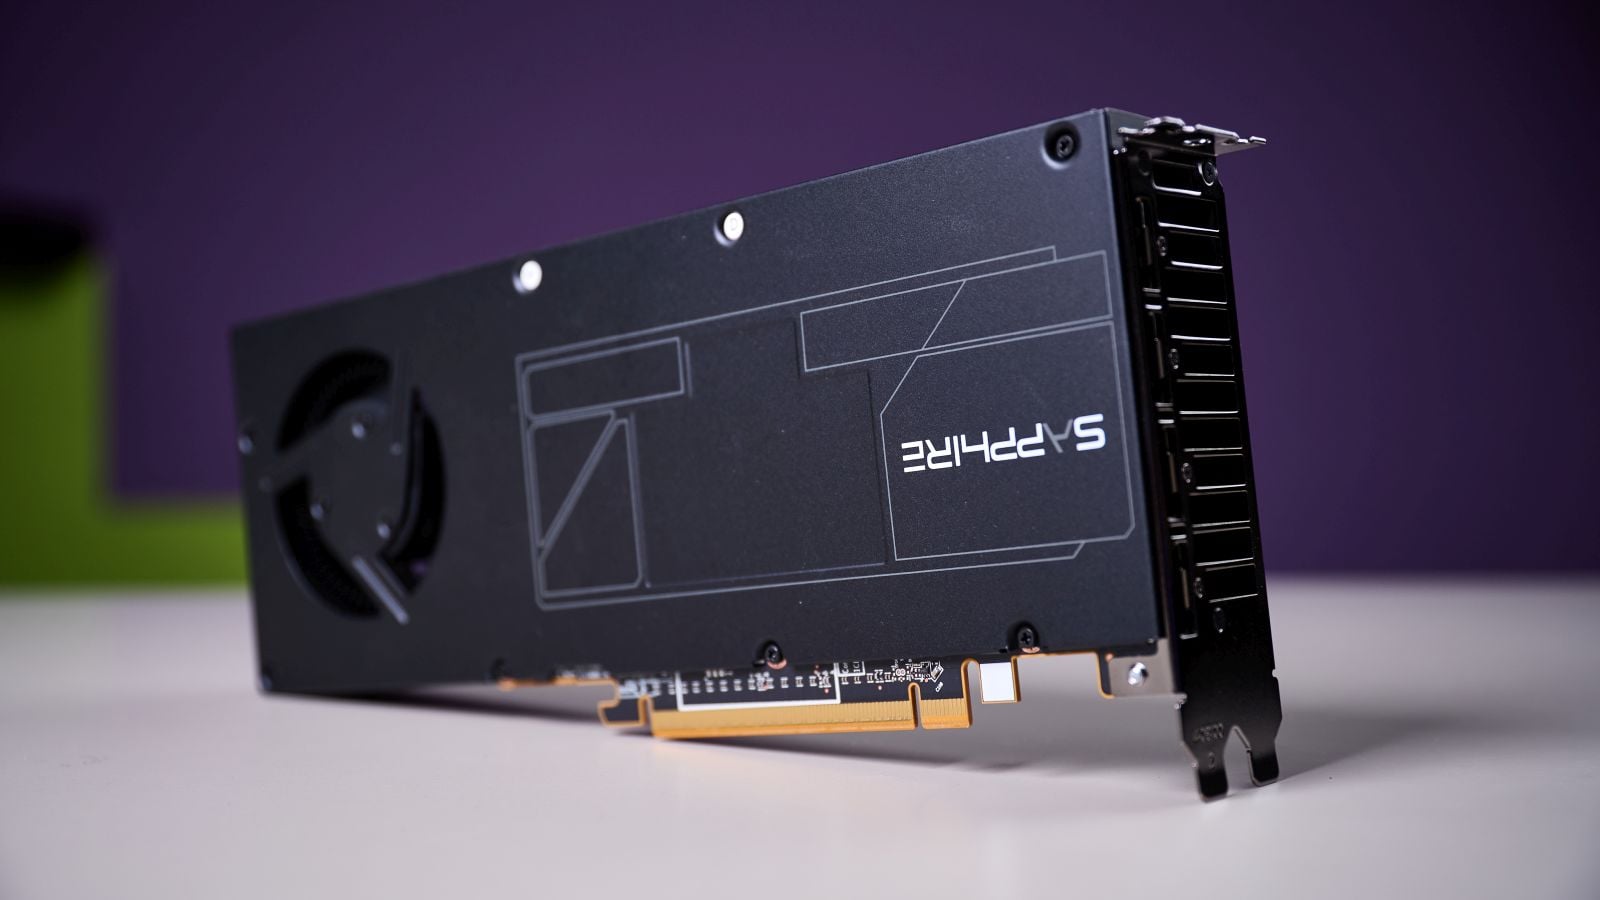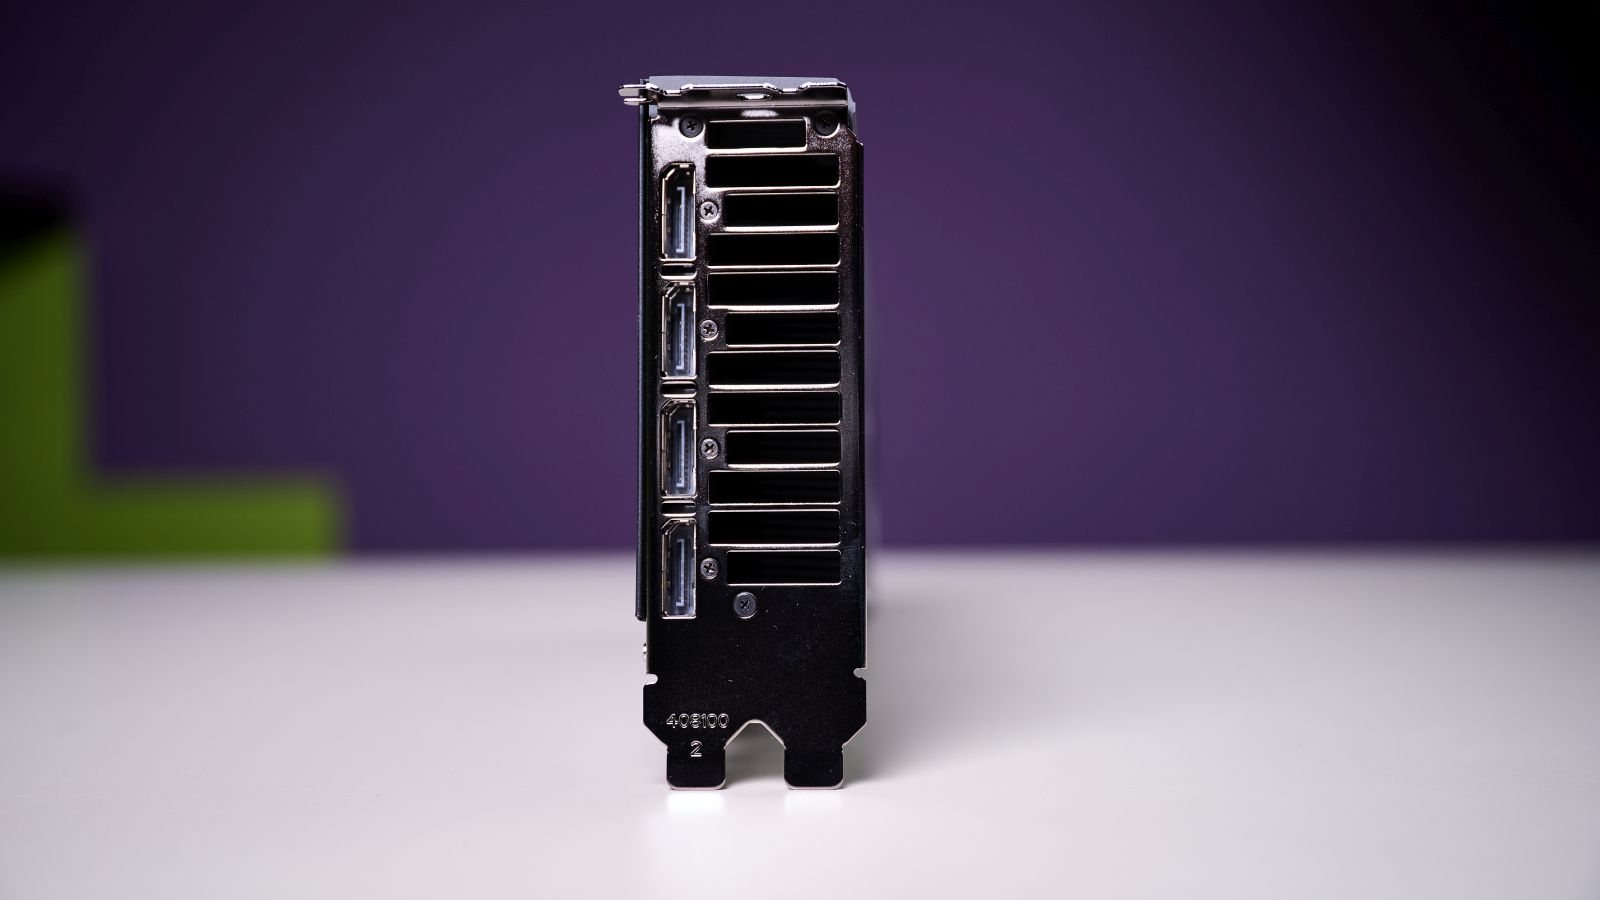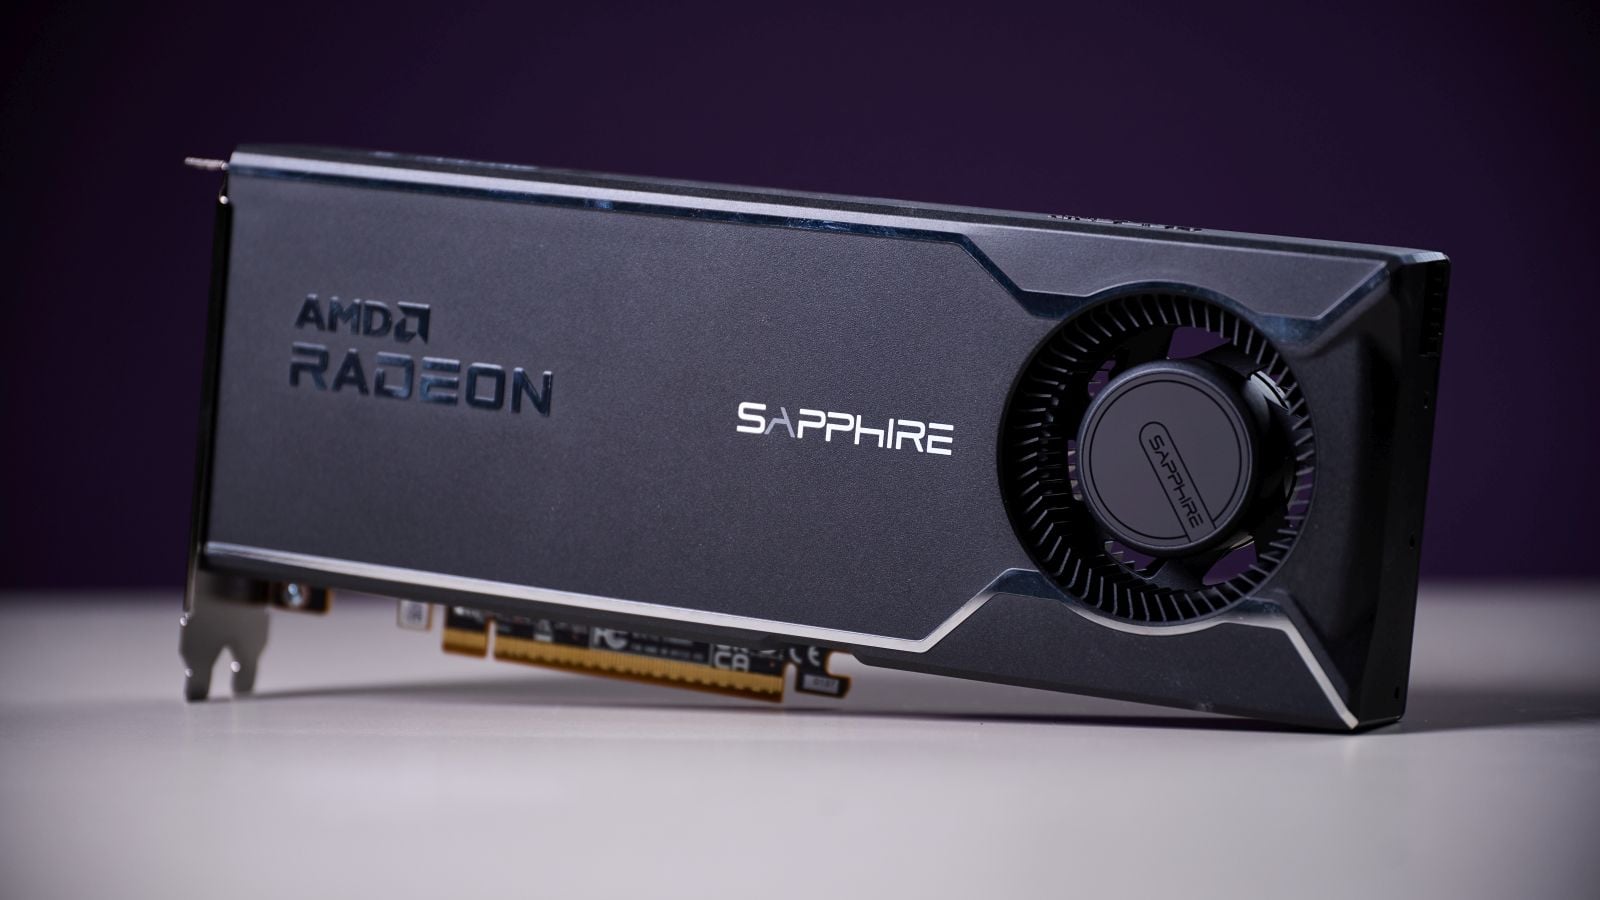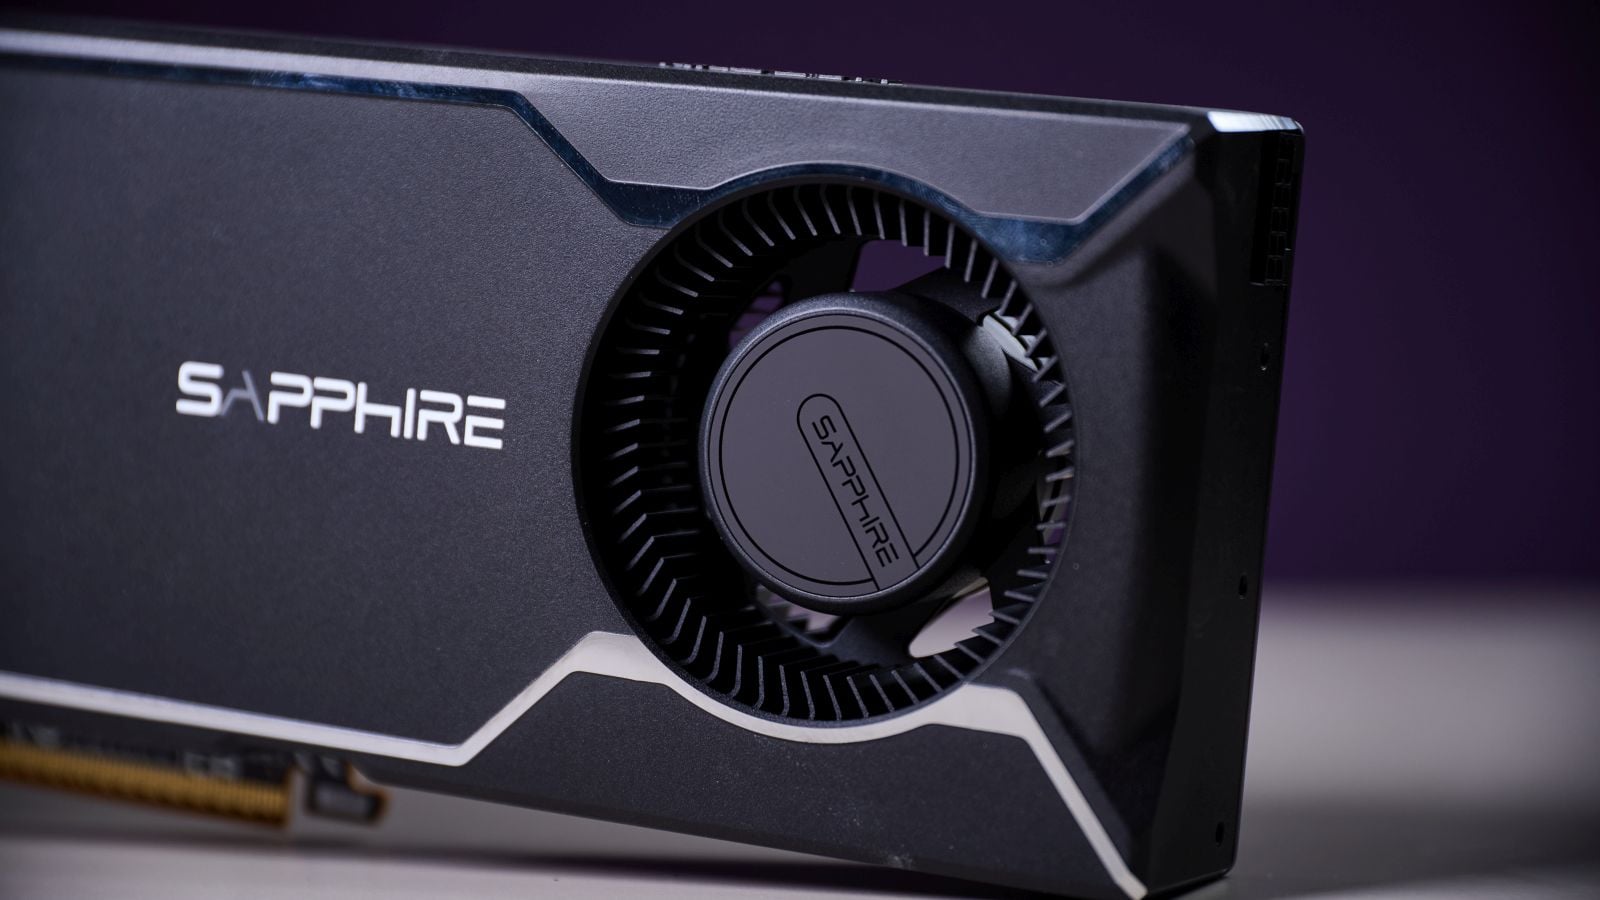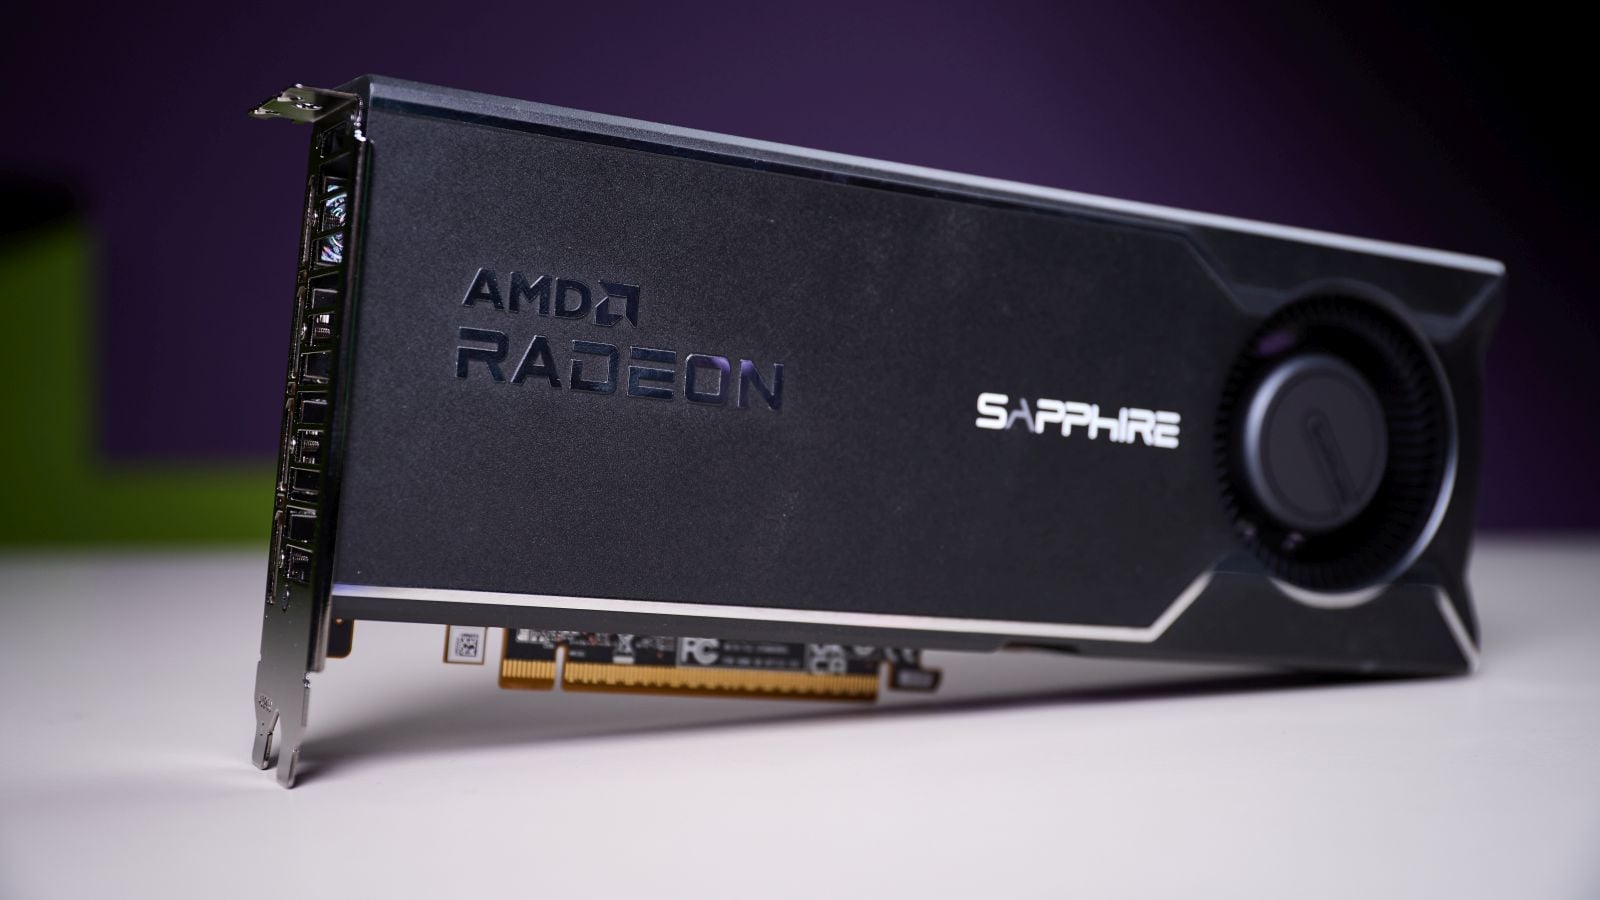
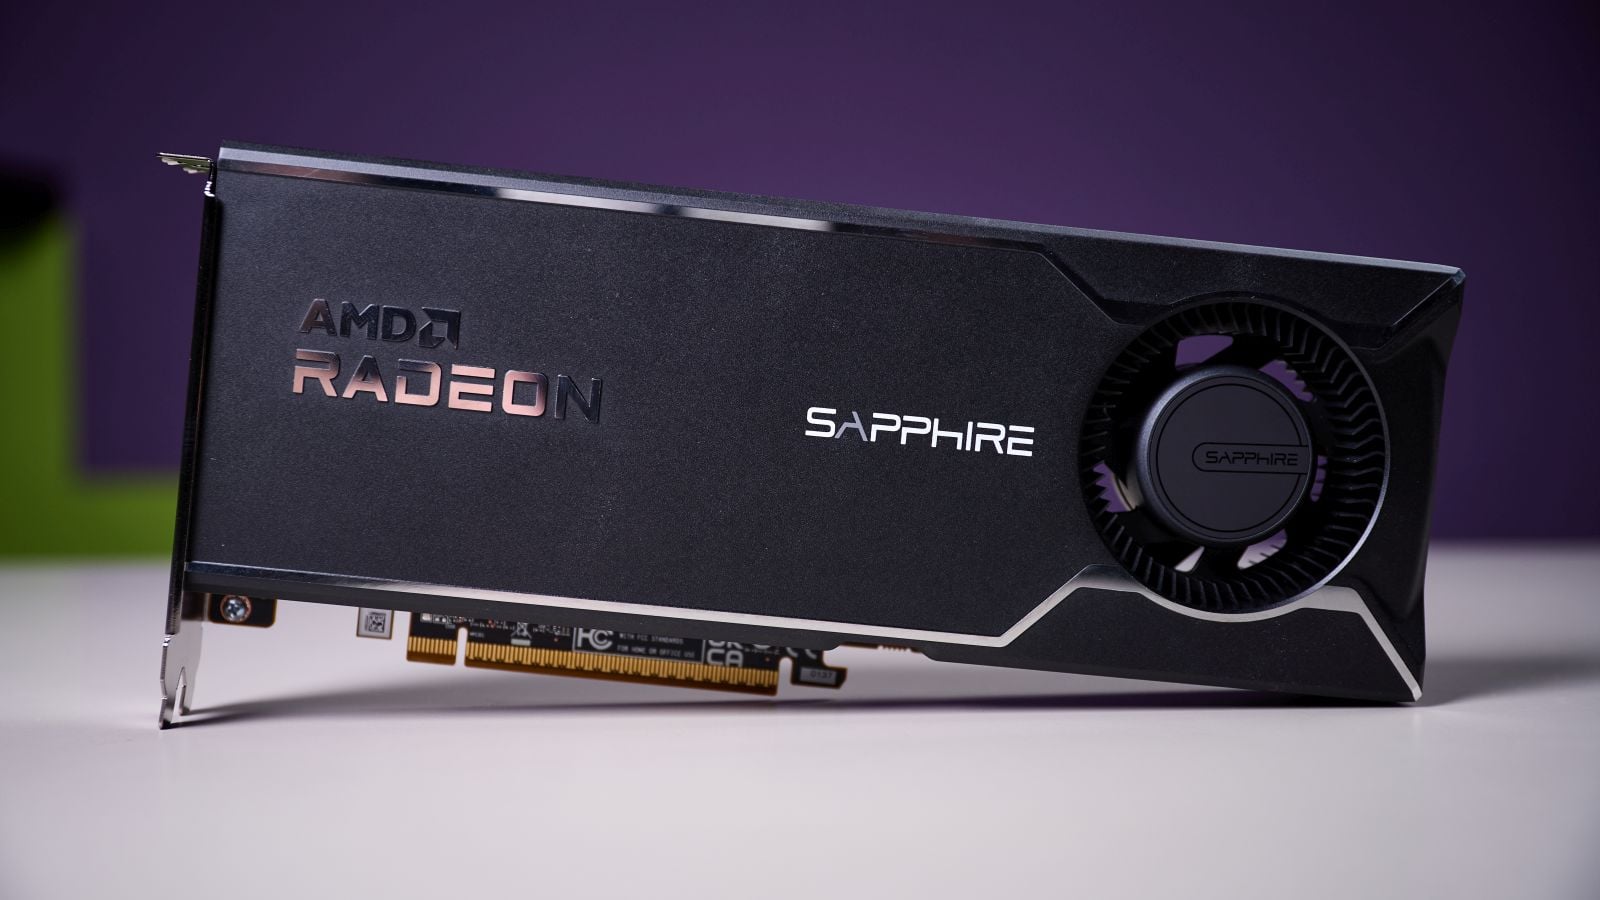





Ti is aggódtok azon, hogy mit kezdenek a nagy tech cégek az adataitokkal? Akkor van egy jó hírünk: ma már nem kötelező elküldeni semmit sehová. A lokálisan futtatható AI-modellek világa az elmúlt időszakban óriásit fejlődött, és ami pár éve még milliós szerverpark-beruházást igényelt, az ma egyetlen dedikált videókártyával megoldható. A SAPPHIRE AMD Radeon AI PRO R9700 pontosan erre született – és mi kipróbáltuk, hogy a gyakorlatban mit is jelent ez.
Nem játékra való – és ez így van jól
Elsőre furcsa lehet egy olyan videókártyáról beszélni, ami nem a legújabb AAA-játékokat célozza meg, hanem kifejezetten mesterséges intelligencia futtatására lett tervezve. A SAPPHIRE AMD Radeon AI PRO R9700 – már a neve is elárulja – egy célhardver: lokális nagy nyelvi modellek (LLM-ek) üzemeltetésére optimalizálták. A lényeg a VRAM-ban rejlik, hiszen a lokális modellfuttatásnál a videómemória mérete határozza meg, mekkora modellt tudunk betölteni és milyen sebességgel dolgozhatunk vele.
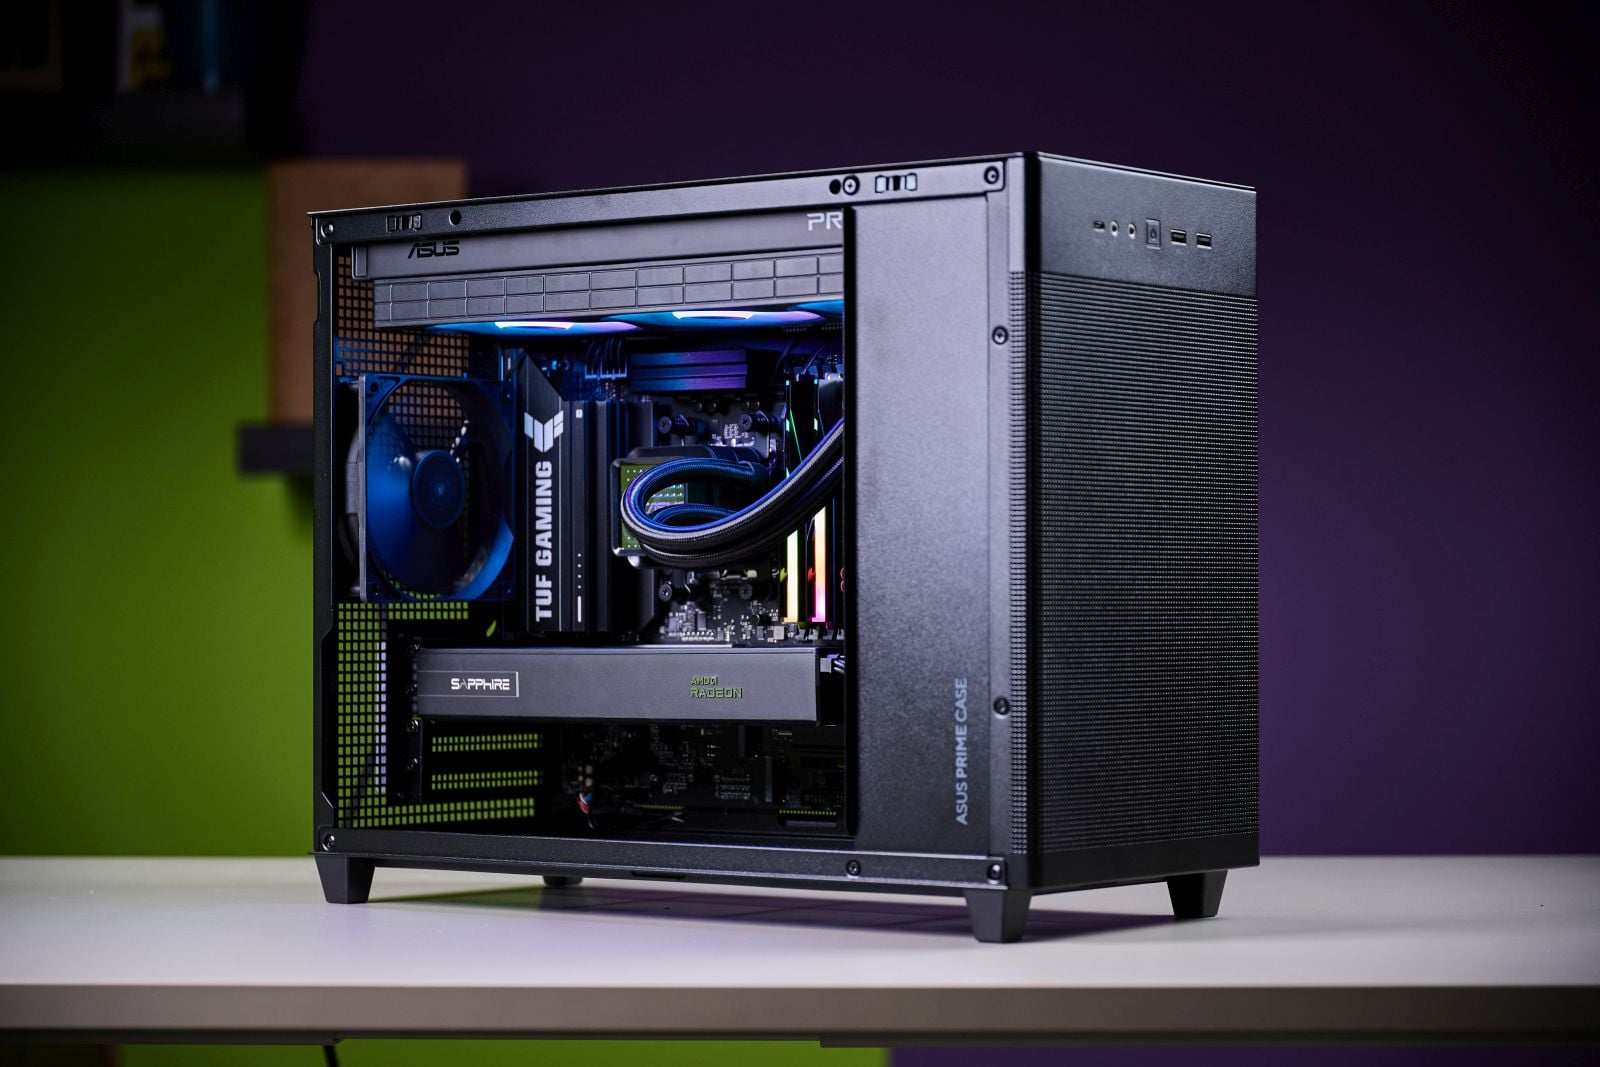
A tesztkonfigurációban egy AMD Ryzen 7-es processzor mellett kapott helyet a kártya, 32 GB rendszer-RAM-mal kiegészítve. De a hangsúly nem a rendszermemórián volt, hanem azon, hogy a videókártya saját VRAM-jából mennyit és milyen hatékonyan tud kiszolgálni. A cél egyértelmű: a modell a GPU-n fusson, ne a CPU-n – mert a sebesség itt dől el.
Mire jó a lokális AI? – és kinek éri meg
Mielőtt a teszteredményekbe merülnénk, érdemes tisztázni, kinek és miért fontos egyáltalán a lokális modellfuttatás. A válasz egy szóban: adatbiztonság. Aki szenzitív üzleti adatokkal, ügyfél-információkkal, belső dokumentumokkal dolgozik, az jogosan aggódhat amiatt, hogy ezek egy felhőszolgáltató szerverén landolnak – még ha az adott szolgáltató szabályzata szerint nem is használják fel azokat betanításra.
A lokális futtatás esetén az adat sosem hagyja el a gépet. Nincs API-hívás, nincs felhő, nincs harmadik fél. Ami a gépen történik, az a gépen marad. Ez különösen a GDPR-érzékeny európai piac számára lehet kulcsfontosságú – legyen szó ügyvédi irodáról, egészségügyi szolgáltatóról vagy pénzügyi tanácsadóról.
Fontos megjegyzés az árazáshoz: az R9700-as az iPon kínálatában is kapható, és ha a teljes gépkonfigurációt nézzük, nagyjából 1 millió Ft környékén alakul egy használható összeállítás. Ez első ránézésre soknak tűnik, de tegyük perspektívába: ha valaki kizárólag az ingyenes futtatás miatt váltana lokálisra, az egy ChatGPT Plus vagy Claude Pro előfizetés havi díjából számolva durván 9-10 évnyi előfizetésnek felel meg. Tehát pusztán spórolásból nem éri meg – de adatvédelmi és üzleti szempontból viszont felbecsülhetetlen értékű lehet.
A tesztkörnyezet: LM Studio és Qwen 3.5
A teszteléshez az LM Studio alkalmazást használtuk (lmstudio.ai), ami jelenleg az egyik legegyszerűbb módja annak, hogy bárki letöltsön és futtasson nyílt forráskódú modelleket a saját gépén. A kezelőfelület rendkívül intuitív: kiválasztjuk a modellt, letöltjük, és már chatelhetünk is vele – pontosan úgy, mint egy ChatGPT-vel, csak éppen minden a saját hardverünkön történik.
A tesztalany a Qwen 3.5 modellcsalád volt, két változatban: egy kisebb, 9 milliárd paraméteres (9B) és egy komolyabb, 35 milliárd paraméteres (35B) verzió. Utóbbit Q8-as kvantálásban futtattuk – ez egy enyhe tömörítés, ami a modell méretét csökkenti a VRAM-ba való beférés érdekében, miközben az eredeti teljesítmény nagyjából 95-97%-át megőrzi. A kvantálás lényegében olyan, mintha egy számot kevesebb tizedesjegyre kerekítenénk: van némi pontosságveszteség, de a gyakorlatban szinte észrevehetetlen.
A tesztek: kreatív írástól kódolásig
Kreatív szövegírás – a kávézós teszt
Első feladatként egy szövegírási tesztet adtunk: írj egy rövid, vicces hirdetést egy budapesti kávézónak, ami reggel 5-kor nyit. Koránkelő Kávézó néven, álmos IT-soknak és koránkelő nagymamáknak, szójátékkal és akciós ajánlattal, maximum 100 szóban.
A 9B-s modell próbálkozott elsőre, de a magyar nyelvtan helyenként megbicsaklott, a szójátékok erőltetettek voltak, és az összhatás inkább volt zavaros, mint szórakoztató. A sebesség viszont lenyűgöző: 86 token/másodperc, gondolkodási móddal együtt. Egy egyszerű kérdésre gondolkodás nélkül 102 token/s sebességgel érkezett a válasz – ez villámgyors.
A 35B-s modell viszont meglepően jó szöveget szült. „Itt a kávé olyan erős, hogy a Hello World!-höz is jobban ébredsz” – ez már egész használható szójáték egy IT-s közönségnek. „Nálunk nincs bug, csak a Java” – tökéletes célközönség-érzékenység. A sebesség természetesen alacsonyabb volt: 28 token/s, és az átgondolási fázis is hosszabb, nagyjából két percet vett igénybe. De az eredmény érezhetően egy kategóriával feljebb játszik.
Kódolás – aknakereső, pomodoro, kvíz és időjárás-widget
A kódolási teszteknél négy különböző feladatot kapott a modell, mindegyiket egyetlen HTML-fájlba kellett megoldania:
- Aknakereső játék – A 35B-s Qwen gondolkodási módban, nagyjából 3-4 perc alatt készítette el. Az eredmény: rögtön elsőre működő, játszható aknakereső, jól kommentezett magyar kóddal. Nem egy AAA-játék, de a tény, hogy egy lokálisan futó modell elsőre hibátlan, futtatható kódot ad – az önmagában figyelemre méltó.
- Pomodoro időmérő – Ezt gondolkodás nélkül, gyorsan ledarálta. Szünet, újraindítás, váltás – minden működött. A dizájn is teljesen vállalható volt.
- AI-kvíz alkalmazás – 8 kérdéses, négyválaszos kvíz, azonnali visszajelzéssel és végső pontszámmal. A modell saját maga generálta a kérdéseket és válaszokat az AI témakörében – és meglepően releváns, tanulságos kérdéseket hozott. A lokális AI futtatásának előnyeiről szóló kérdést magától találta ki.
- Időjárás-widget – Hardcoded adatokkal, de szép dizájnnal: Budapest, Debrecen, Szeged, Pécs, Győr között lehetett váltogatni. A CSS-munka kifejezetten igényes volt.
Ami igazán lenyűgöző volt: az utolsó két feladatot párhuzamosan futtattuk, két külön chat-ablakban. A videókártya mindkét szálat gond nélkül kiszolgálta – nem akadt meg, nem melegedett túl kritikusan, és bár a hűtés néha felzúgott, messze nem volt zavaró mértékű. Ez arra utal, hogy az R9700 valós munkafolyamatokban is megbízhatóan teljesít, nem csak laboratóriumi single-thread teszteken.
Matematika – a kedvezményszámító
A logikai gondolkodás teszteléséhez egy többlépcsős matematikai feladványt adtunk: egy bolt 20%-os kedvezményt ad minden termékre, és ha az eredeti összeg 50 000 Ft felett van, további 10%-ot kapsz a már kedvezményes árból. Az eredeti ár 75 000 Ft volt – mennyi a végső fizetendő, mennyit spóroltál, és hány százalék az összkedvezmény?
A 35B-s modell lépésről lépésre, hibátlanul vezette le a számítást: 75 000 → 60 000 (20% kedvezmény) → 54 000 (további 10%) → 21 000 Ft megtakárítás, azaz 28%-os összkedvezmény. 26,58 token/s sebességgel, 1,21 másodperces first-token idővel. A logika végig helyes volt – ez bizalmat ad abban, hogy számolási feladatokra is megbízhatóan bevethető.
Képelemzés – a balatoni naplemente
Meglepés-teszt: a Qwen 3.5 35B rendelkezik vision képességgel is, tehát képes képeket elemezni. Egy balatoni naplementés fotót dobtunk be neki azzal a kérdéssel: mi van a képen? A modell gondolkodási fázisában felmerült benne, hogy a kép nagyon hasonlít a Balatonon lévő boglári hegy környékére, bár a végső válaszában óvatosabban fogalmazott. A képleírás tartalmilag pontos volt: naplemente, sétaút, zöld felület, gondozott park. Helymeghatározást nem vállalt be egyértelműen, de a gondolkodási folyamatában ott volt a helyes irány – ez egy 35B-s lokális modelltől kifejezetten jó teljesítmény.
Sebességek összegzése
| Feladat | Modell | Sebesség |
| Egyszerű chat (gondolkodással) | Qwen 3.5 9B | 86 token/s |
| Egyszerű chat (gondolkodás nélkül) | Qwen 3.5 9B | 102 token/s |
| Kreatív szövegírás | Qwen 3.5 35B (Q8) | 28 token/s |
| Matematikai feladat | Qwen 3.5 35B (Q8) | 26,58 token/s |
| Kódolás (párhuzamos) | Qwen 3.5 35B (Q8) | 19 token/s |
A 9B-s modell villámgyors, de összetettebb feladatokra kevés. A 35B-s Q8-as változat a sweet spot: elég okos ahhoz, hogy valós munkát végezzen, és elég gyors ahhoz, hogy ne kelljen perceket várni minden válaszra. A párhuzamos futtatás természetesen lassítja a token-sebességet, de még így is használható marad – ez production-környezetben kulcsfontosságú szempont.
Kinek ajánljuk?
A SAPPHIRE AMD Radeon AI PRO R9700 nem mindenkinek való – és ez rendben is van. Ha valaki egyszerűen szeretné használni az AI-t napi szinten, egy ChatGPT vagy Claude előfizetés olcsóbb és kényelmesebb megoldás. De van egy jól körülhatárolható célközönség, akiknek ez a kártya igazi game-changer lehet:
- Vállalkozások és cégek, ahol az adatbiztonság nem opcionális, hanem alapkövetelmény – ügyvédi irodák, könyvelőirodák, egészségügyi szolgáltatók, pénzügyi tanácsadók
- IT-csapatok, akik belső AI-asszisztenst szeretnének felállítani anélkül, hogy az érzékeny adatok elhagyják a céges hálózatot
- Fejlesztők és AI-rajongók, akik kísérletezni szeretnének nyílt modellekkel, finomhangolással, és ehhez megbízható, gyors hardverre van szükségük
- Tartalomgyártók, akik hanganyagok leiratára, szövegfeldolgozásra vagy képelemzésre használnák a lokális AI-t – mindezúttal úgy, hogy az anyagok sosem hagyják el a gépet
Összegzés
A SAPPHIRE AMD Radeon AI PRO R9700 egy őszinte termék: pontosan azt csinálja, amire tervezték, és abban jól teljesít. Nem próbál játék-videókártya lenni, nem próbál mindenre jó lenni – ehelyett a lokális AI-futtatás területén kínál meggyőző teljesítményt, kiszámítható működést és valós használhatóságot. A Qwen 3.5 35B-s modellel végzett tesztek azt mutatják, hogy ma már egy közepes paraméterszámú nyílt modell is képes értelmes kreatív szövegeket írni, működő kódot generálni, matematikai feladatokat megoldani és képeket elemezni – mindezt lokálisan, adatszivárgás kockázata nélkül.
A párhuzamos feladatvégzés stabilitása és a konzisztens token-sebességek azt jelzik, hogy ez a kártya nem csak hobbieszköz, hanem komoly munkaállomások építőköve lehet. Vaskos árcédulájával nem impulzusvásárlás, de aki érti, mire kell – annak megtérülő befektetés.